一条每天定时跑的写教程流水线:Muse 负责找选题,Claude 动手实测并写稿,GPT 独立审稿,人只负责早上挑题、晚上按合并键。核心就一条:写稿的和审稿的必须是不同家的模型。
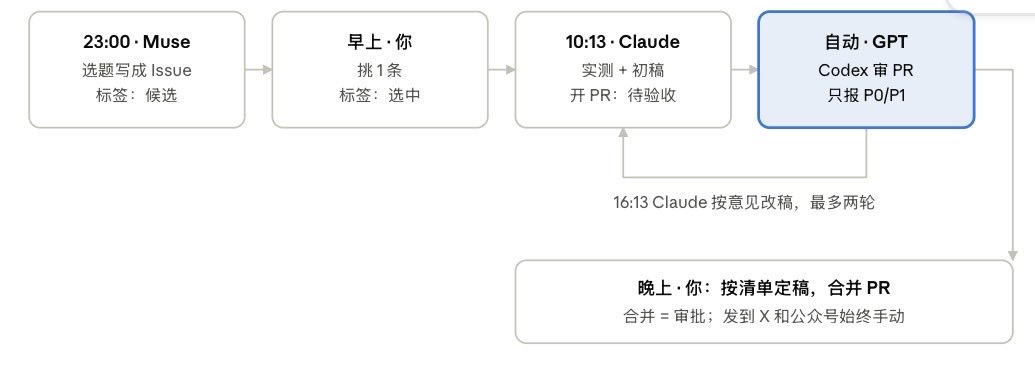
为什么不能一个模型包圆?一个模型从找题写到审稿,最大的问题是自己审自己,它永远觉得自己写得对。所以这条流水线把三家模型用一个私密 GitHub 仓库串起来当“总线”:Issue 是选题队列,PR 是稿件,标签表示现在轮到谁,人合并 PR 就是审批。
每天的流转是这样的:23:00 Muse 从当天推送里挑最多 3 个最值得写的选题建成 Issue;早上人挑 1 个打上“选中”;10:00 Claude 定时认领,实测、写稿、开 PR;PR 一开,GPT 就自动审稿;16:00 Claude 按审稿意见改,最多两轮,不过就交给人;晚上人定稿、合并、手动发布。任何内容都不会自动发出去,发布键永远在人手里。
最重要的一条是先实测再写。教程最怕“看起来对,照着做跑不通”,所以 Claude 每做一步,都要把命令和输出存进 evidence 文件夹;GPT 审稿时逐步对照,稿子里有、证据里没有的步骤直接打回。
文末附的 4 条提示词可以直接抄思路:Muse 选题入库时只读只推送、不点领取链接、不注册不付款,福利、赚钱、免费额度类信息一律标“未验证”,建 Issue 前先搜已有 Issue 去重,灰色教程不建;Claude 写稿时只处理带“选中”标签且还没有 PR 的最早一个 Issue,先实测再写稿,能跑的命令真的跑并存证据,跑不了的写“【截图】”或“【待作者实测】”占位,只写实测过或明确标注的步骤;GPT 审稿时当独立审稿人不改写正文,每个操作步骤都要在 evidence 里找到对应输出,版本号、命令、价格、免费额度说法不一致或无来源标 P1,读者照做可能付费、封号、丢数据却没有提醒的标 P0;Claude 处理审稿意见时逐条判断对错,对就改并说明改了什么,不对就回复理由并指出证据文件,第三轮还有 P0/P1 就停下加“需人工”标签。