腾讯混元把实时中英同声传译模型 Hy-SimulMT 开源了:边听边译,语音和文字双输出,同传这件事的门槛被直接打了下来。
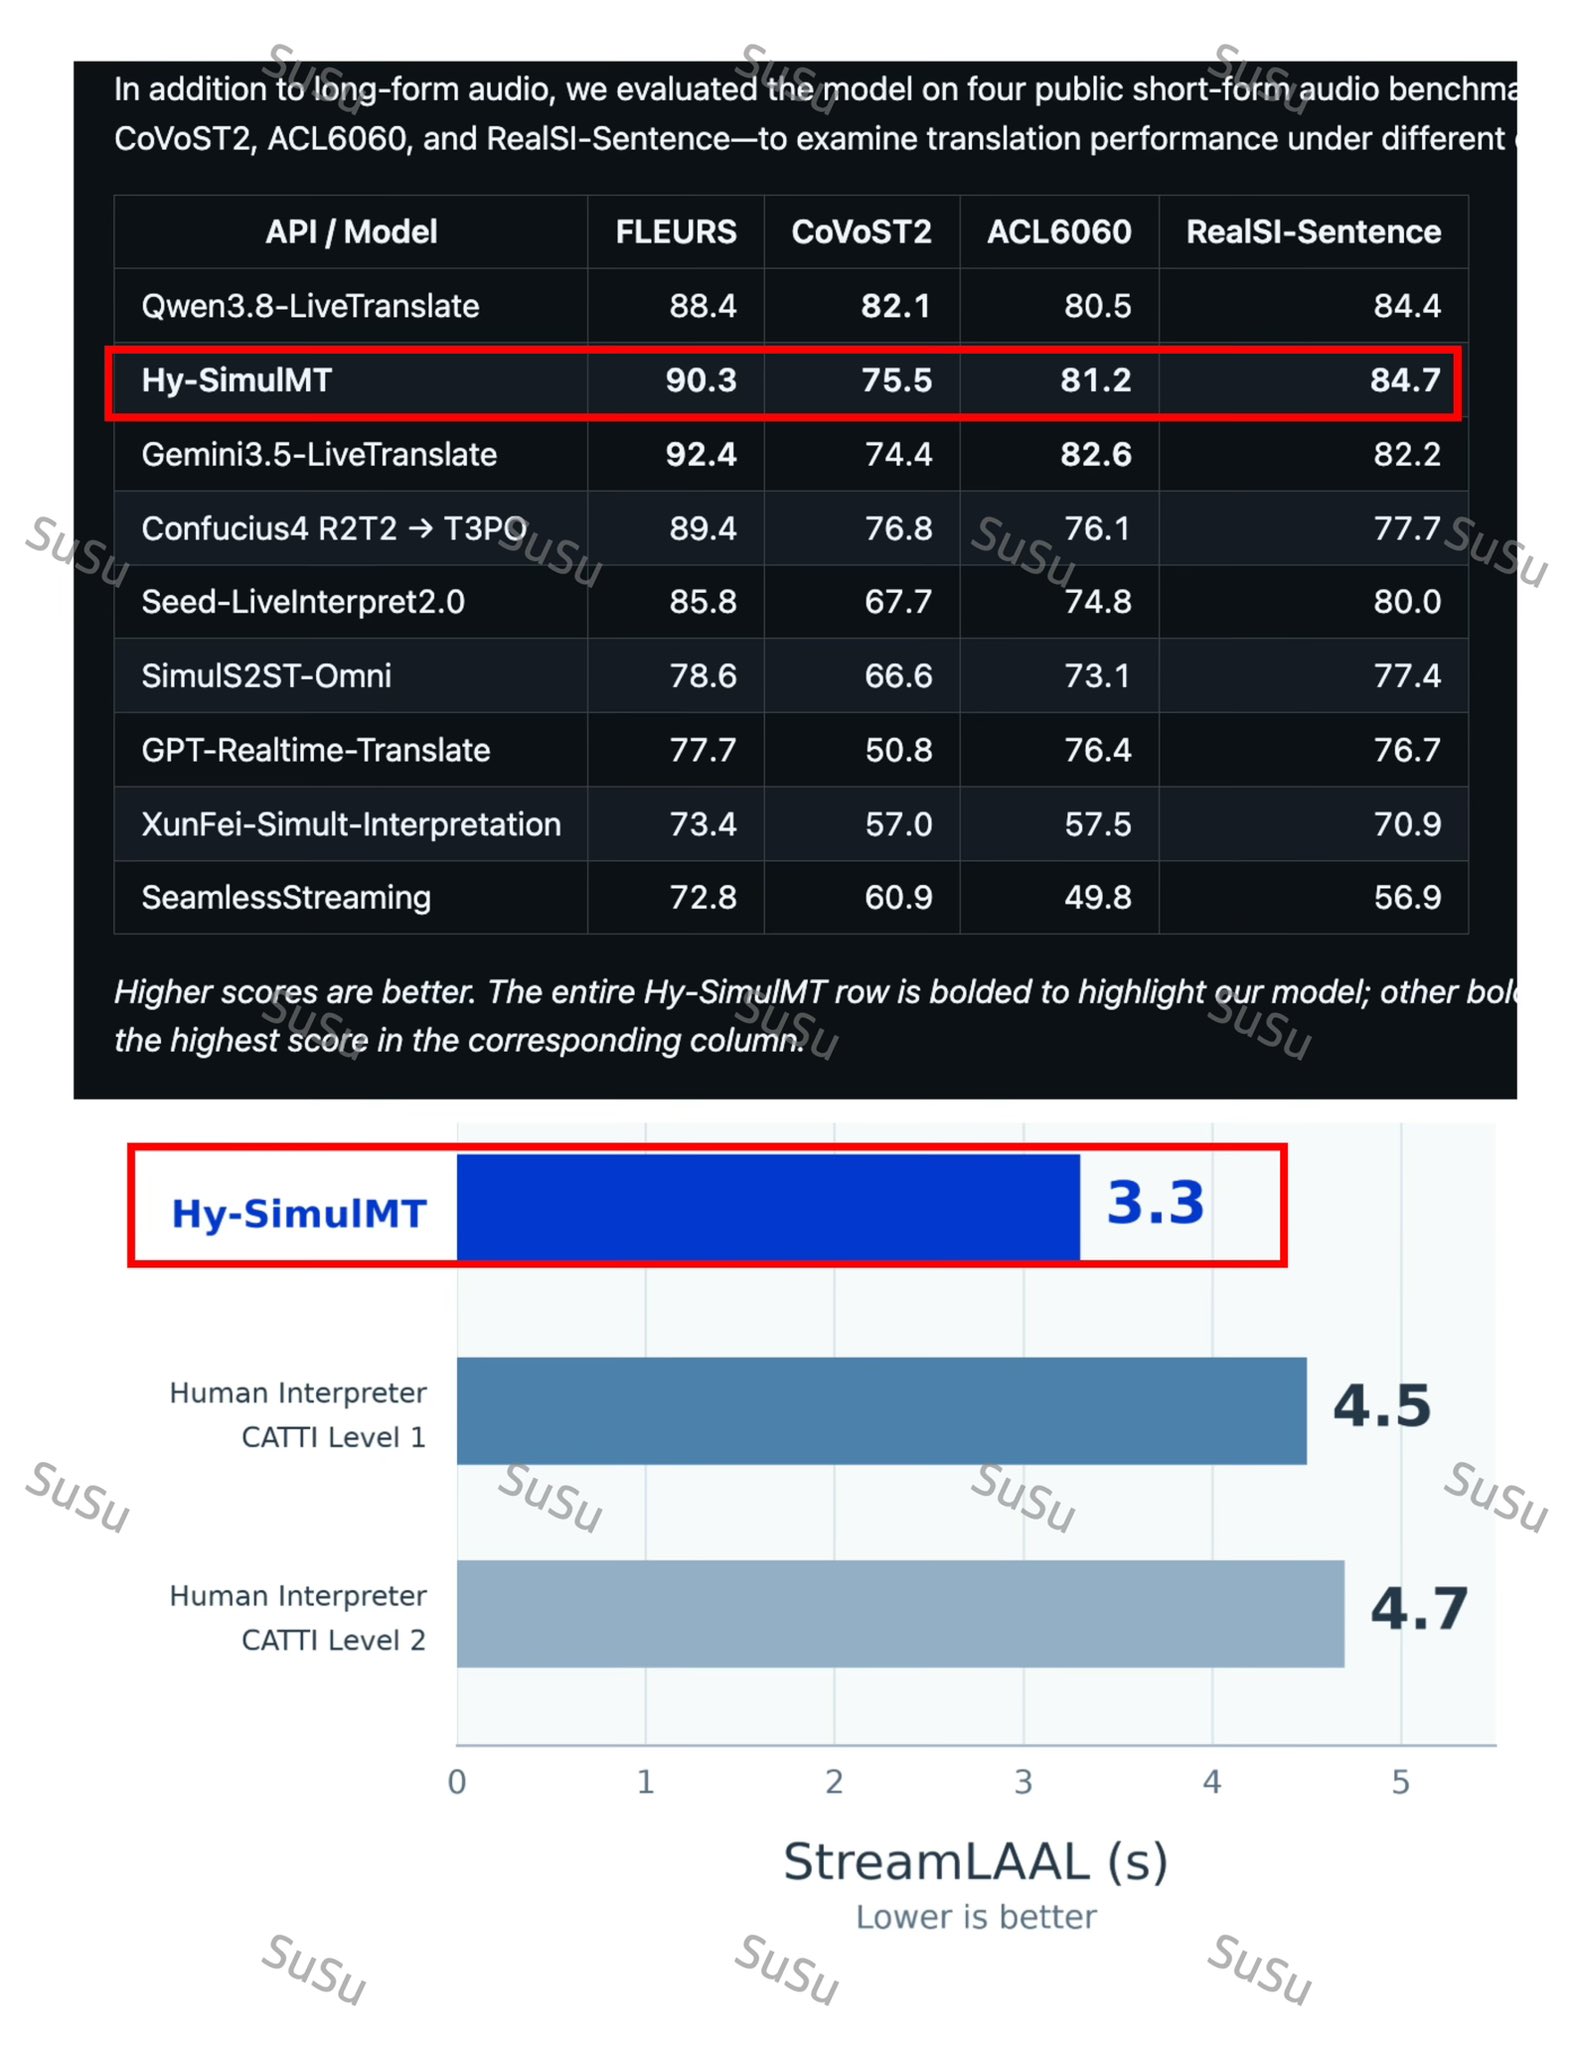
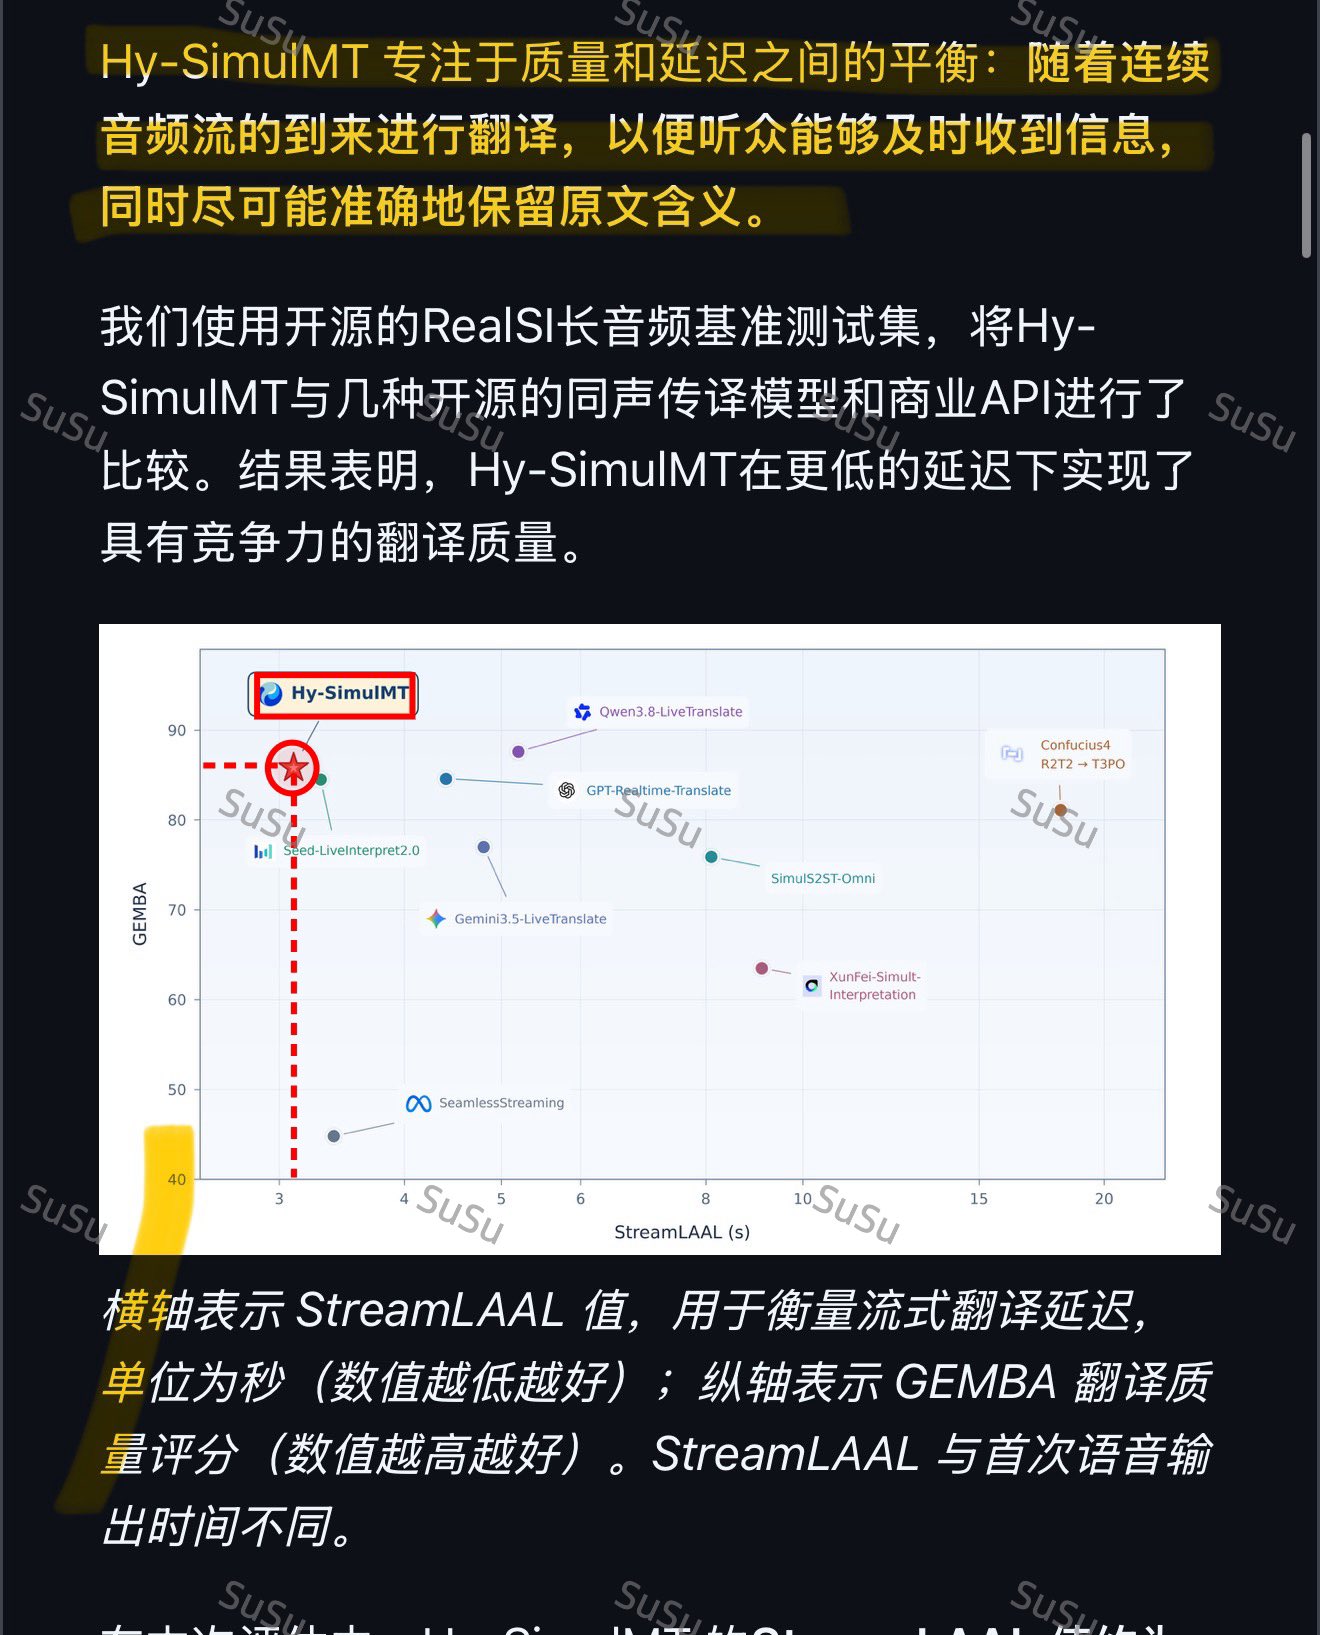
先看三个硬指标。延迟上,长音频实测 StreamLAAL 约 3 秒,比同类系统低,也快于人类专业译员平均 4–5 秒;质量上,GEMBA 得分超过多数开源模型,还优于 5 个商业 API 中的 4 个;另外支持实时音色克隆,译文内容准确的同时保留说话人自己的声音特点。
架构是 30B-A3B 的 MoE,总参约 30.4B、实际激活约 3B,提供仅译文和原文+译文交错(Interleave)两个版本,还有 FP8、GGUF 量化,部署成本可控。
上手路径也很短:去 Hugging Face 或 ModelScope 下载权重(Apache 2.0 协议),用官方 SimulInfer 搭推理服务(支持 WebSocket 和 Web UI,需要 vLLM),再配一个 TTS 服务(比如 Qwen3-TTS)就能实现语音输出和实时音色克隆。嫌麻烦也可以直接打开「Hy翻译」App 免费体验。
会议、直播、跨境沟通这些需要即时跨语言的场景,现在可以直接拿它搭一套自己的同传服务。
项目地址:GitHub | 权重下载:Hugging Face | ModelScope
正文完