给 Muse 一个公众号文章链接,拿回两份东西:一份干净的 Markdown 全文,一份结构化 JSON。不用付费 API,不用登录,也不用准备任何账号和 API Key。
拿到的 article.md 里有元信息头(标题、公众号、作者、发布时间、原文链接、图片数)加 Markdown 正文,图片按正文顺序嵌回对应位置;article.json 里是结构化字段(title、account、author、publishtime、sourceurl、contentmarkdown、contenttext、images、stats),可以喂给其他程序、知识库或下一个 Bot。
适合把公众号长文搬进自己的素材库、给选题做原文存档,或者把好文章转成可检索的文本。开始前只需要一篇公众号文章链接,在微信里打开文章,右上角菜单复制链接即可。
第一步,把链接和要求一次说清。对 Muse 说:“把这篇公众号文章抓成 Markdown,再给我一份 JSON。要求:标题、公众号、作者、发布时间齐全;正文要全文不要摘要;图片按正文顺序收录原图链接并嵌回对应位置。(粘贴链接)”
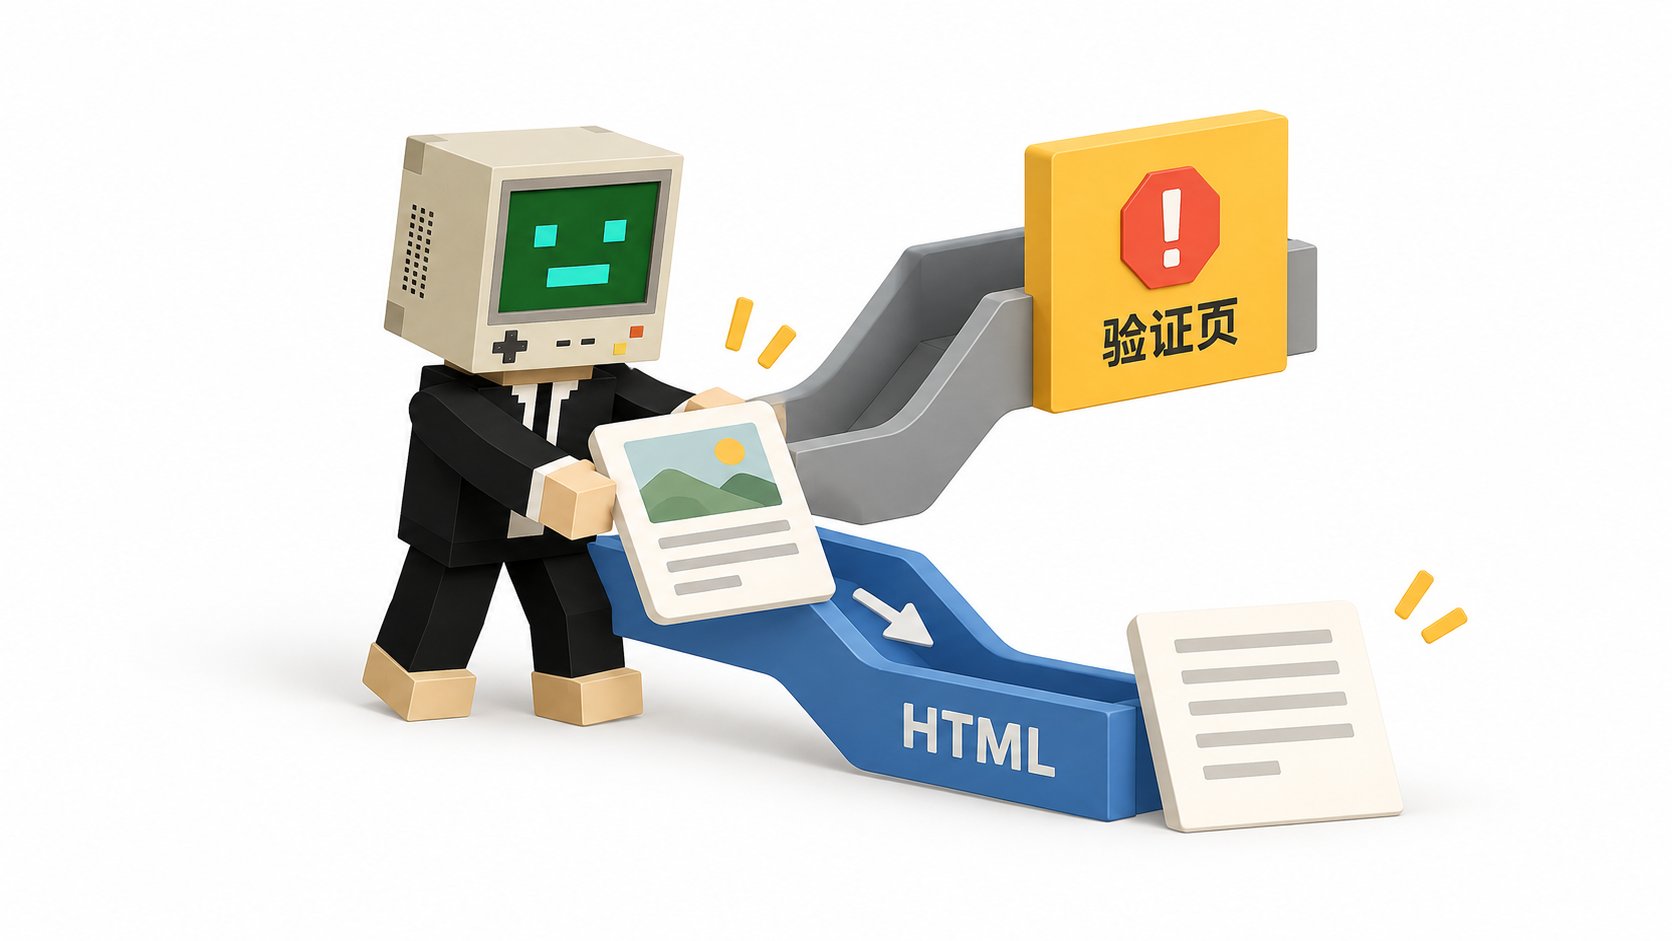
第二步,如果 Muse 说被验证页拦住,别慌,这是已知坑。常规的页面读取通道打开微信链接时,会撞上微信的“环境异常”验证页,拿不到正文。正确解法是换通道:让 Muse 用命令行直接取原始 HTML 再解析。如果它反复用同一通道重试,提醒它一句:“换直取 HTML 的方式。”
第三步,盯住两个最容易漏的字段。发布时间藏在页面脚本的一个时间戳变量里,不是明文,首轮实跑就漏了它;作者名在页面上有隐藏和可见两个同名元素,粗心的解析会把作者名抓两遍。验收时拿作者名和你在微信里看到的对照一眼即可。
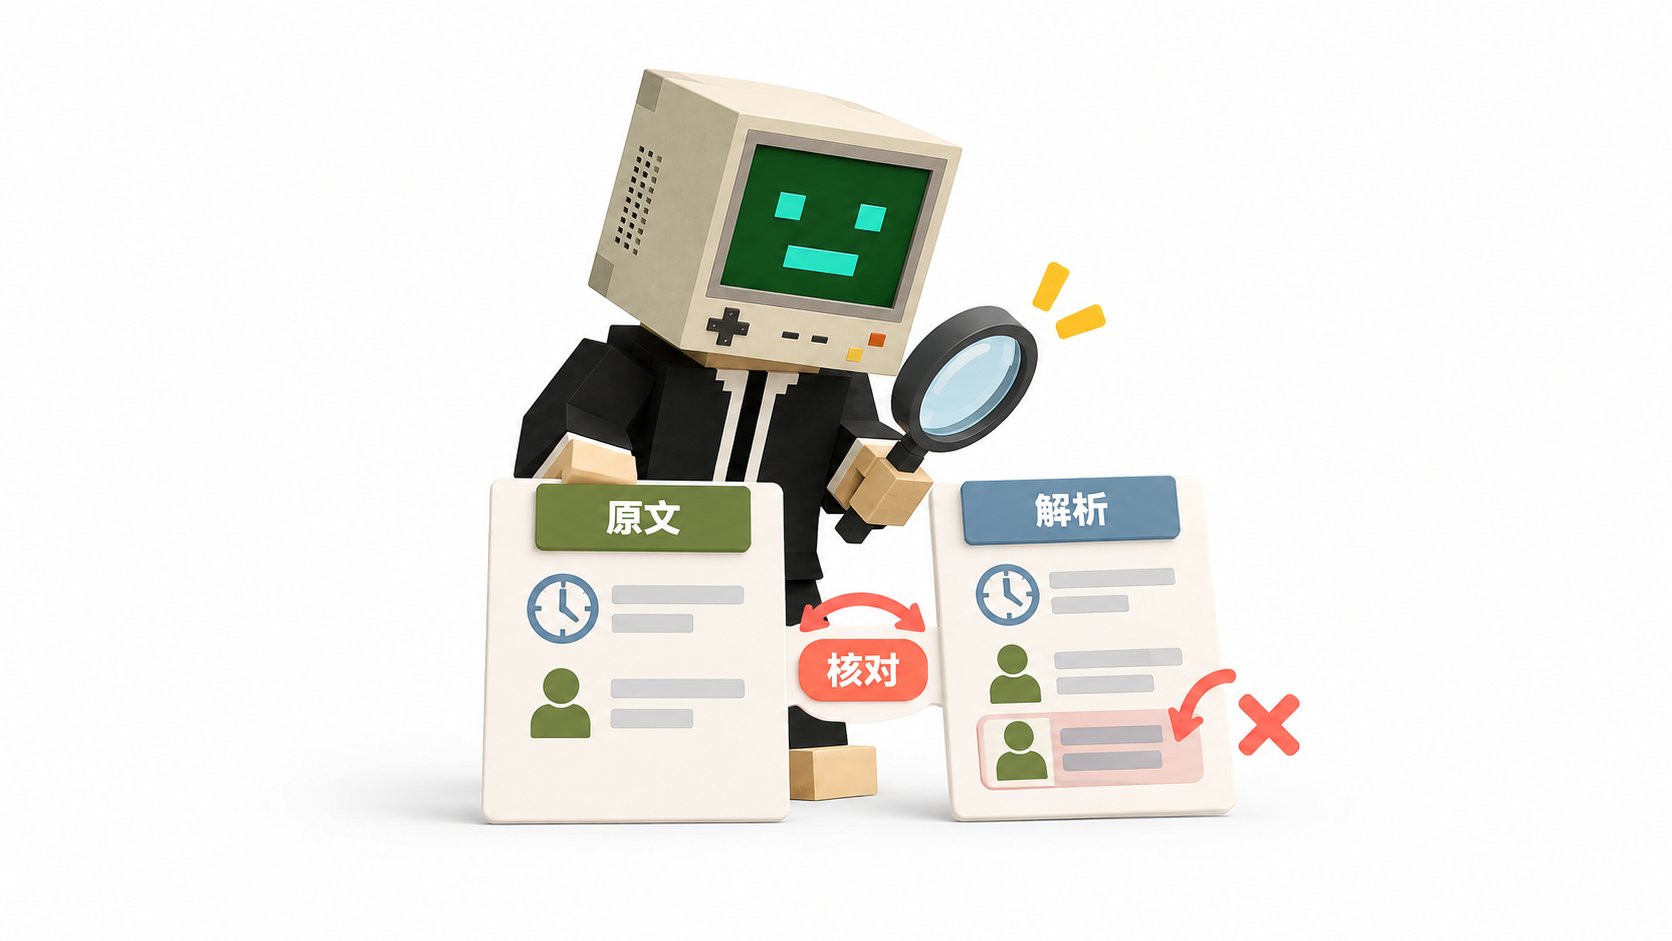
第四步,照单逐项验收:标题与原文一致;公众号名称正确;发布时间精确到分钟;正文从首段读到文末最后一节,中途没有“……(省略)”式的截断;文末出现公众号的往期推荐页脚是正常的,说明抓到了底;图片数量与原文大致对得上,且图片出现在对应的段落位置;JSON 能打开、字段齐全。
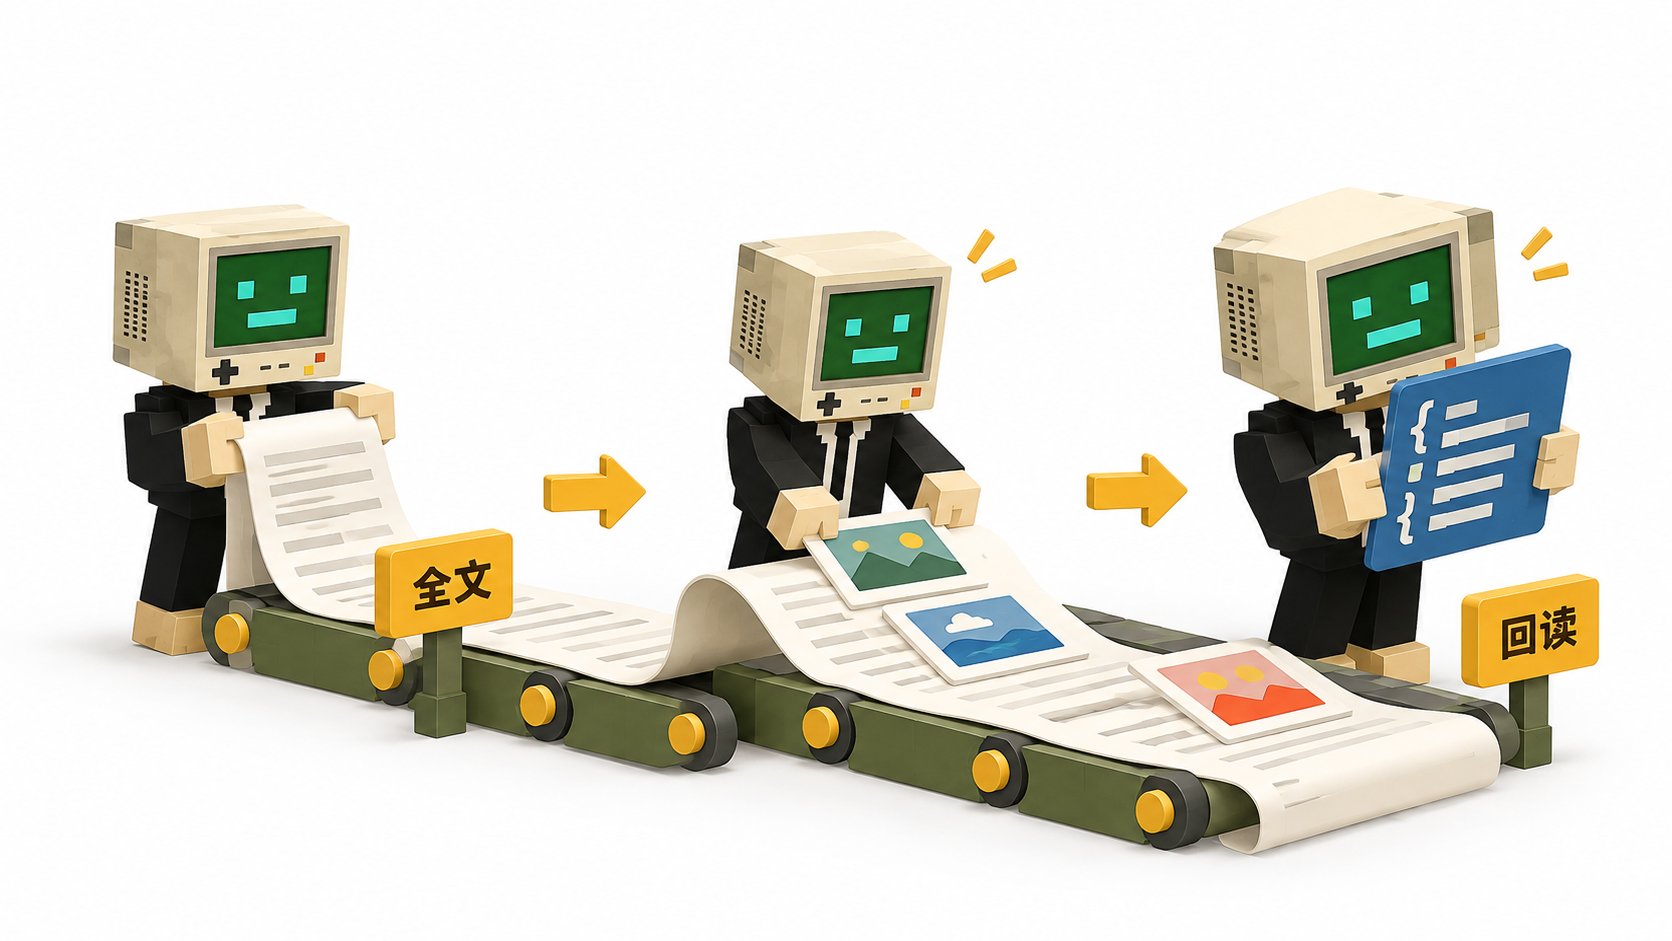
实跑证据:样本文章《ACM MM 2026|华中师大 CoReFuse-Med:先净化再融合,让低质模态不再拖后腿》,公众号「多模态信息融合」,正文 2762 字完整无截断、图片 38 张,标题、公众号、作者、发布时间逐项核对无误。方法流水是搜索引擎先定位转载页再找到原文链接,页面读取被验证页拦截后换命令行直取 HTML(4.26 MB,约 26 秒),解析两轮修正后全字段命中。
示例文章链接:
https://mp.weixin.qq.com/s/SVr9DmtPyzORLYad-tNR-g
几个常见问题:抓回来的正文是空的或只有标题,多半是被验证页拦了,按第二步换通道;仍不行就换个时间重试,网络出口被标记是环境问题。能批量抓,一次给多条链接、让 Muse 逐篇产出同结构的 md+json 即可,每篇之间留间隔,别把请求打成一串连发。抓付费或仅粉丝可见的文章不行,也不要绕,本方法只处理公开可访问的文章。
边界也说清楚:抓取结果供个人学习与素材管理使用;整篇转载他人原文发布涉及版权,引用时请注明出处、控制篇幅。