大模型内部到底在忙什么?一张图把 12 个关键机制一次讲清了:输入进来之后,先算关联、再加工特征、最后生成下一个词,整个过程分四组。
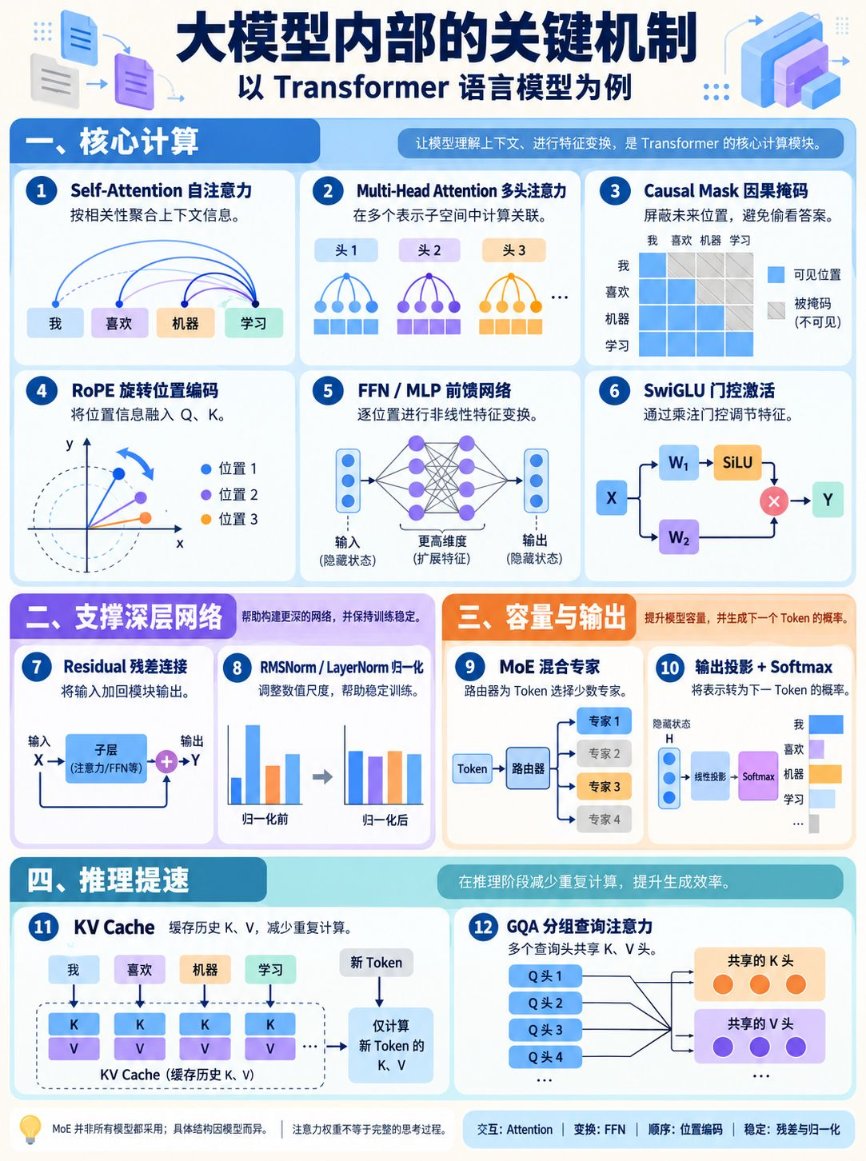
第一组是核心计算。Self-Attention 自注意力按相关性聚合上下文信息;Multi-Head Attention 多头注意力在多个表示子空间中算关联;Causal Mask 因果掩码屏蔽未来位置,避免偷看答案;RoPE 旋转位置编码把位置信息融入 Q、K;FFN / MLP 前馈网络逐位置进行非线性特征变换;SwiGLU 门控激活通过乘法门控调节特征。
第二组支撑深层网络。Residual 残差连接把输入加回模块输出,让更深的网络训得稳;RMSNorm / LayerNorm 归一化调整数值尺度,帮助稳定训练。
第三组管容量与输出。MoE 混合专家由路由器为每个 Token 选择少数专家;输出投影 + Softmax 把表示转为下一个 Token 的概率。
第四组是推理提速。KV Cache 缓存历史 K、V,只算新 Token 的 K、V,减少重复计算;GQA 分组查询注意力让多个查询头共享 K、V 头。
两个提醒:MoE 并非所有模型都采用,具体结构因模型而异;注意力权重不等于完整的思考过程,别把注意力图直接当成模型的推理链。
正文完