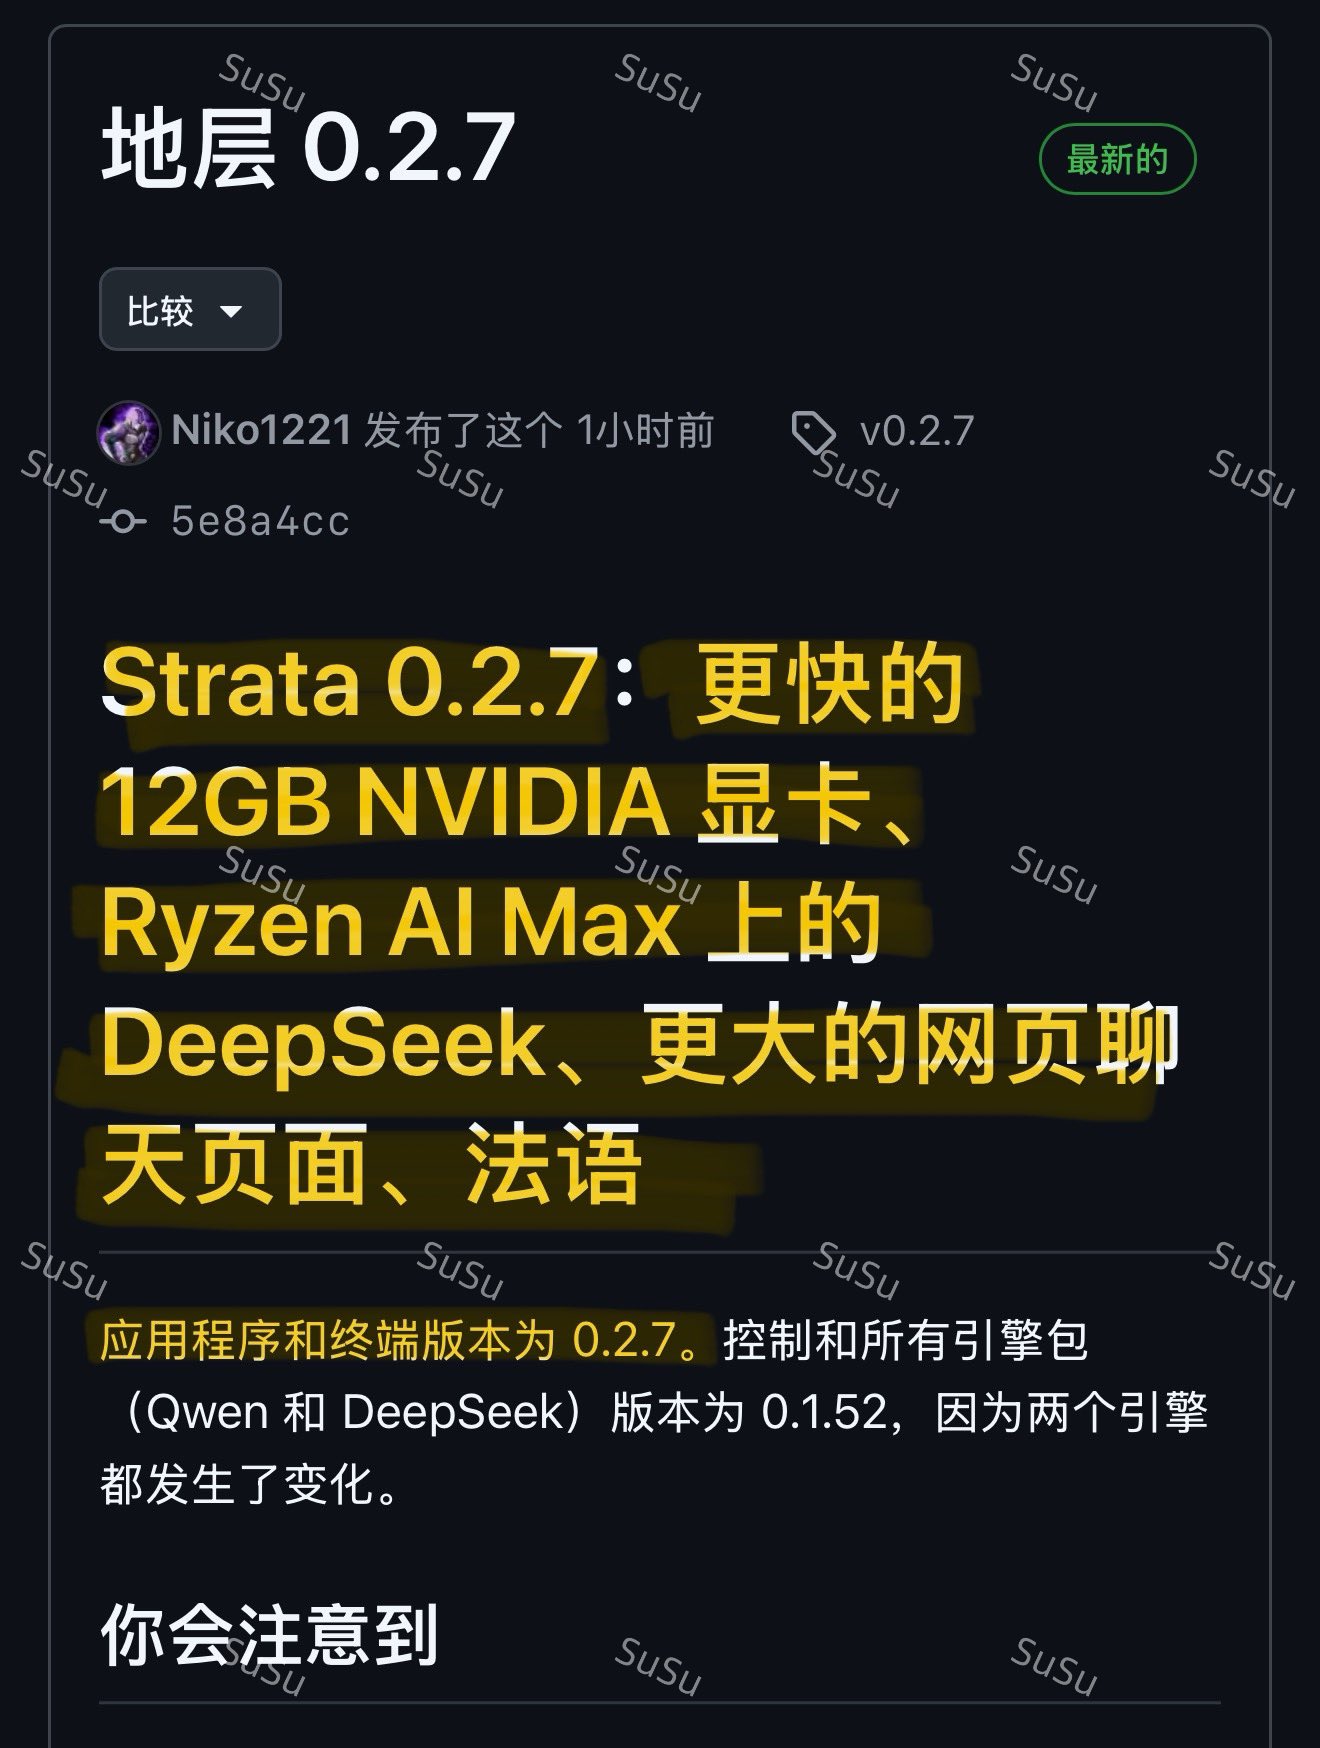
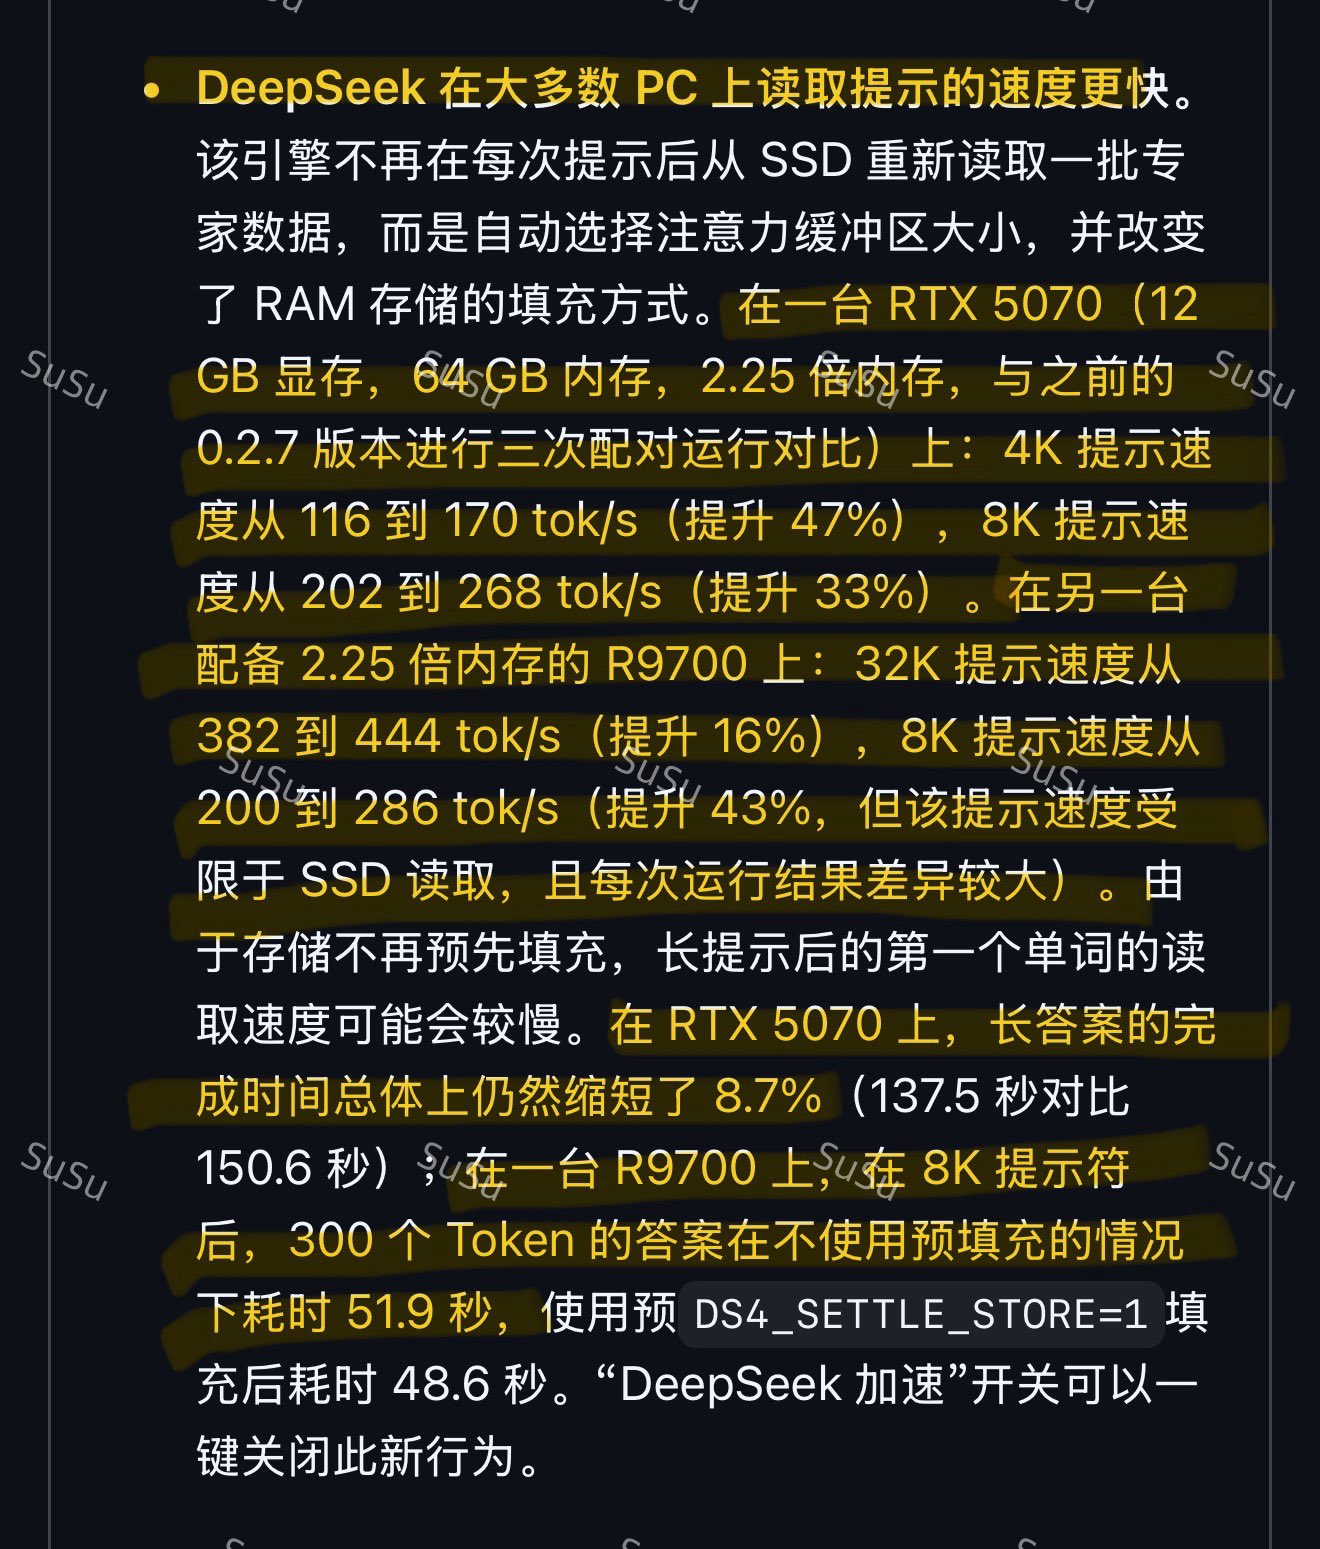
Strata 0.2.7 来了,DeepSeek-V4.1-Flash-1017 在本地跑又快了一截。这次动的是提示词处理:引擎不再每次提示后都从 SSD 重读一批专家数据,而是自动选注意力缓存大小、改了 RAM 的填充方式。官方给的最高数字是提示速度提升 65%。
先看消费级卡上的实测。RTX 5070(12GB 显存、64GB 内存):4K 提示从 116 涨到 170 tok/s,提升 47%;8K 提示从 202 涨到 268 tok/s,提升 33%。R9700 上 32K 提示从 382 涨到 444 tok/s,提升 16%;8K 提示从 200 涨到 286 tok/s,提升 43%,不过这项受 SSD 读取限制,每次跑的结果波动比较大。长答案的整体完成时间也没拖后腿,RTX 5070 上缩短了 8.7%,137.5 秒对比 150.6 秒。
新支持的硬件值得单独说一句:Ryzen AI Max(Strix Halo)现在 Windows 原生就能跑 DeepSeek,4K 到 32K 最高 300+ tok/s。4 张 R9700 默认走 5 experts 模式,暖启动提示快 40% 以上,质量几乎不变。上下文也放宽到 512K/1M,Vision 默认开启。12GB 的卡加一块大内存,跑 DeepSeek-V4.1-Flash-1017 比以前顺多了。
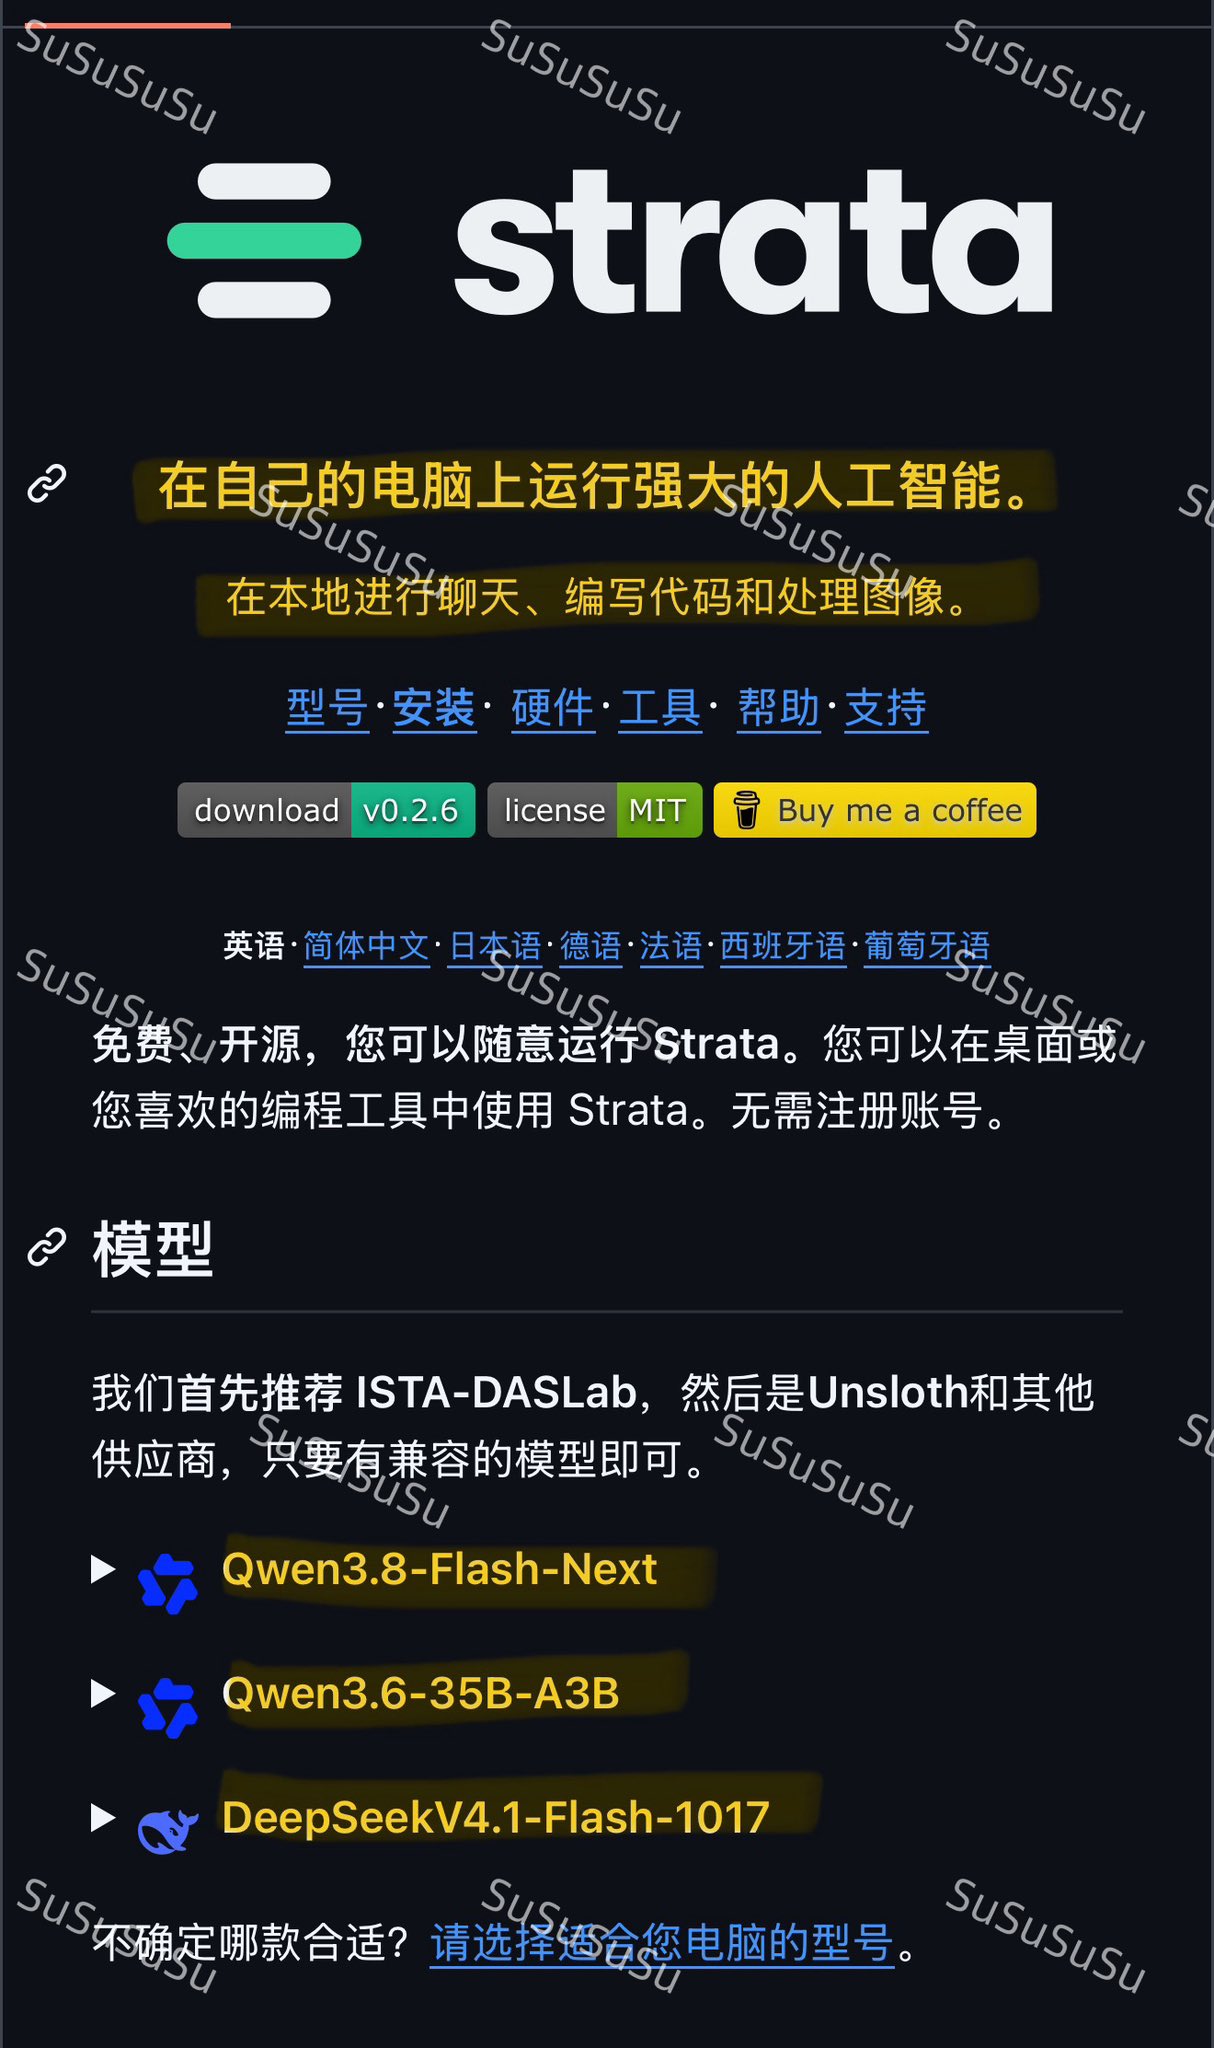
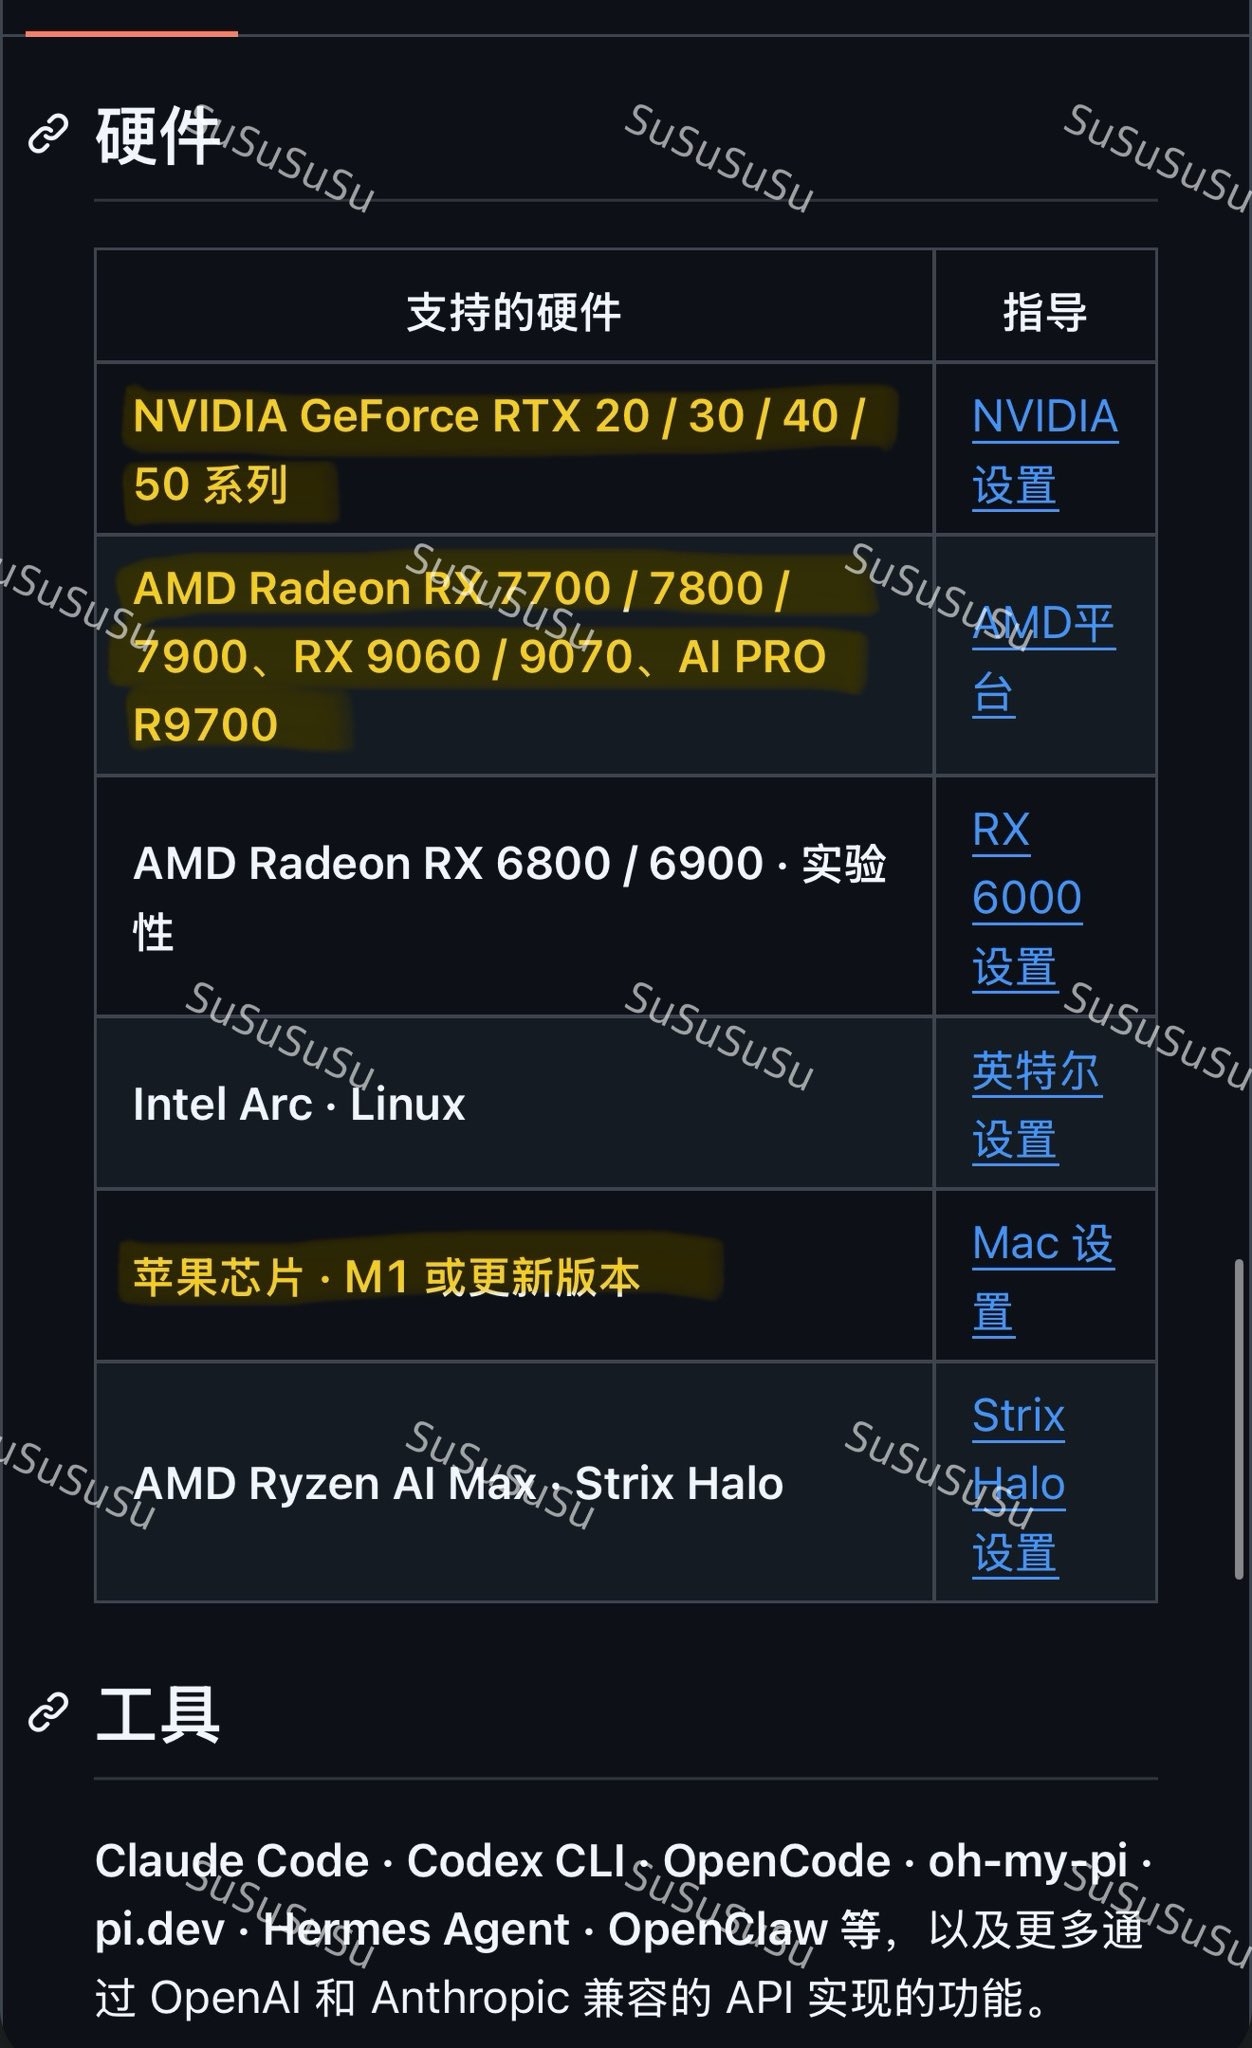
硬件覆盖面也摆在这了:NVIDIA RTX 20/30/40/50 系、AMD RX 7700/7800/7900、RX 9060/9070、AI PRO R9700、苹果 M1 及更新芯片、Ryzen AI Max Strix Halo。除了本地聊天,还能接 Claude Code、Codex CLI、OpenCode 这些编程工具。Strata 本身免费开源,不用注册账号。
提醒两点:内存不再预先填充,长提示后的第一个词可能慢一点;不想用这个新行为,打开“DeepSeek 加速”开关就能一键关掉。另外留个参照:上一版 0.2.6 在 RTX 4080 Super(16G 显存、128G 内存、8K 上下文)上,生成速度从约 10 t/s 提到了 16.7–22.7 t/s。
下载地址:
https://github.com/Niko1221/Strata/releases/tag/v0.2.7