64GB 内存、3090 24GB 加 4060 Ti 16GB,换更大的模型到底值不值?这份实测用 Strata 部署 Qwen3.8-Flash-Next,256K 窗口,对照原有的 Qwen3.8-27B,还拿 Luna 做了回答质量参照。先说结论:第二张卡主要省在读长材料的首字等待上;质量上开思考后 Flash 和 27B 互有胜负;这篇没证明的事,作者也都写明了。
机器与部署
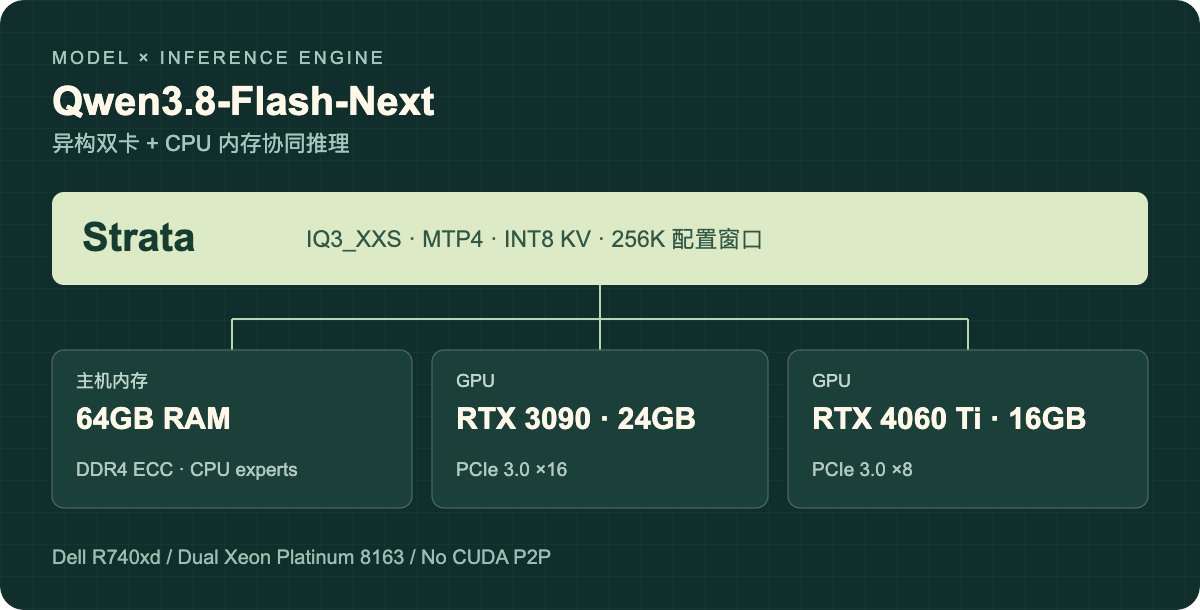
Dell R740xd,双路 Xeon Platinum 8163,64GB DDR4 ECC,RTX 3090 24GB(PCIe 3.0 x16)加 RTX 4060 Ti 16GB(PCIe 3.0 x8),没有 CUDA P2P。模型用 ISTA-DASLab 的 GSQ-RCO IQ3_XXS 量化,两分片合计约 75.84GB,Strata v0.2.4、MTP4、INT8 KV,窗口 262144。官方模型卡列出 125B 参数、每 token 约 6B 激活。
第二张卡,主要省在首字等待
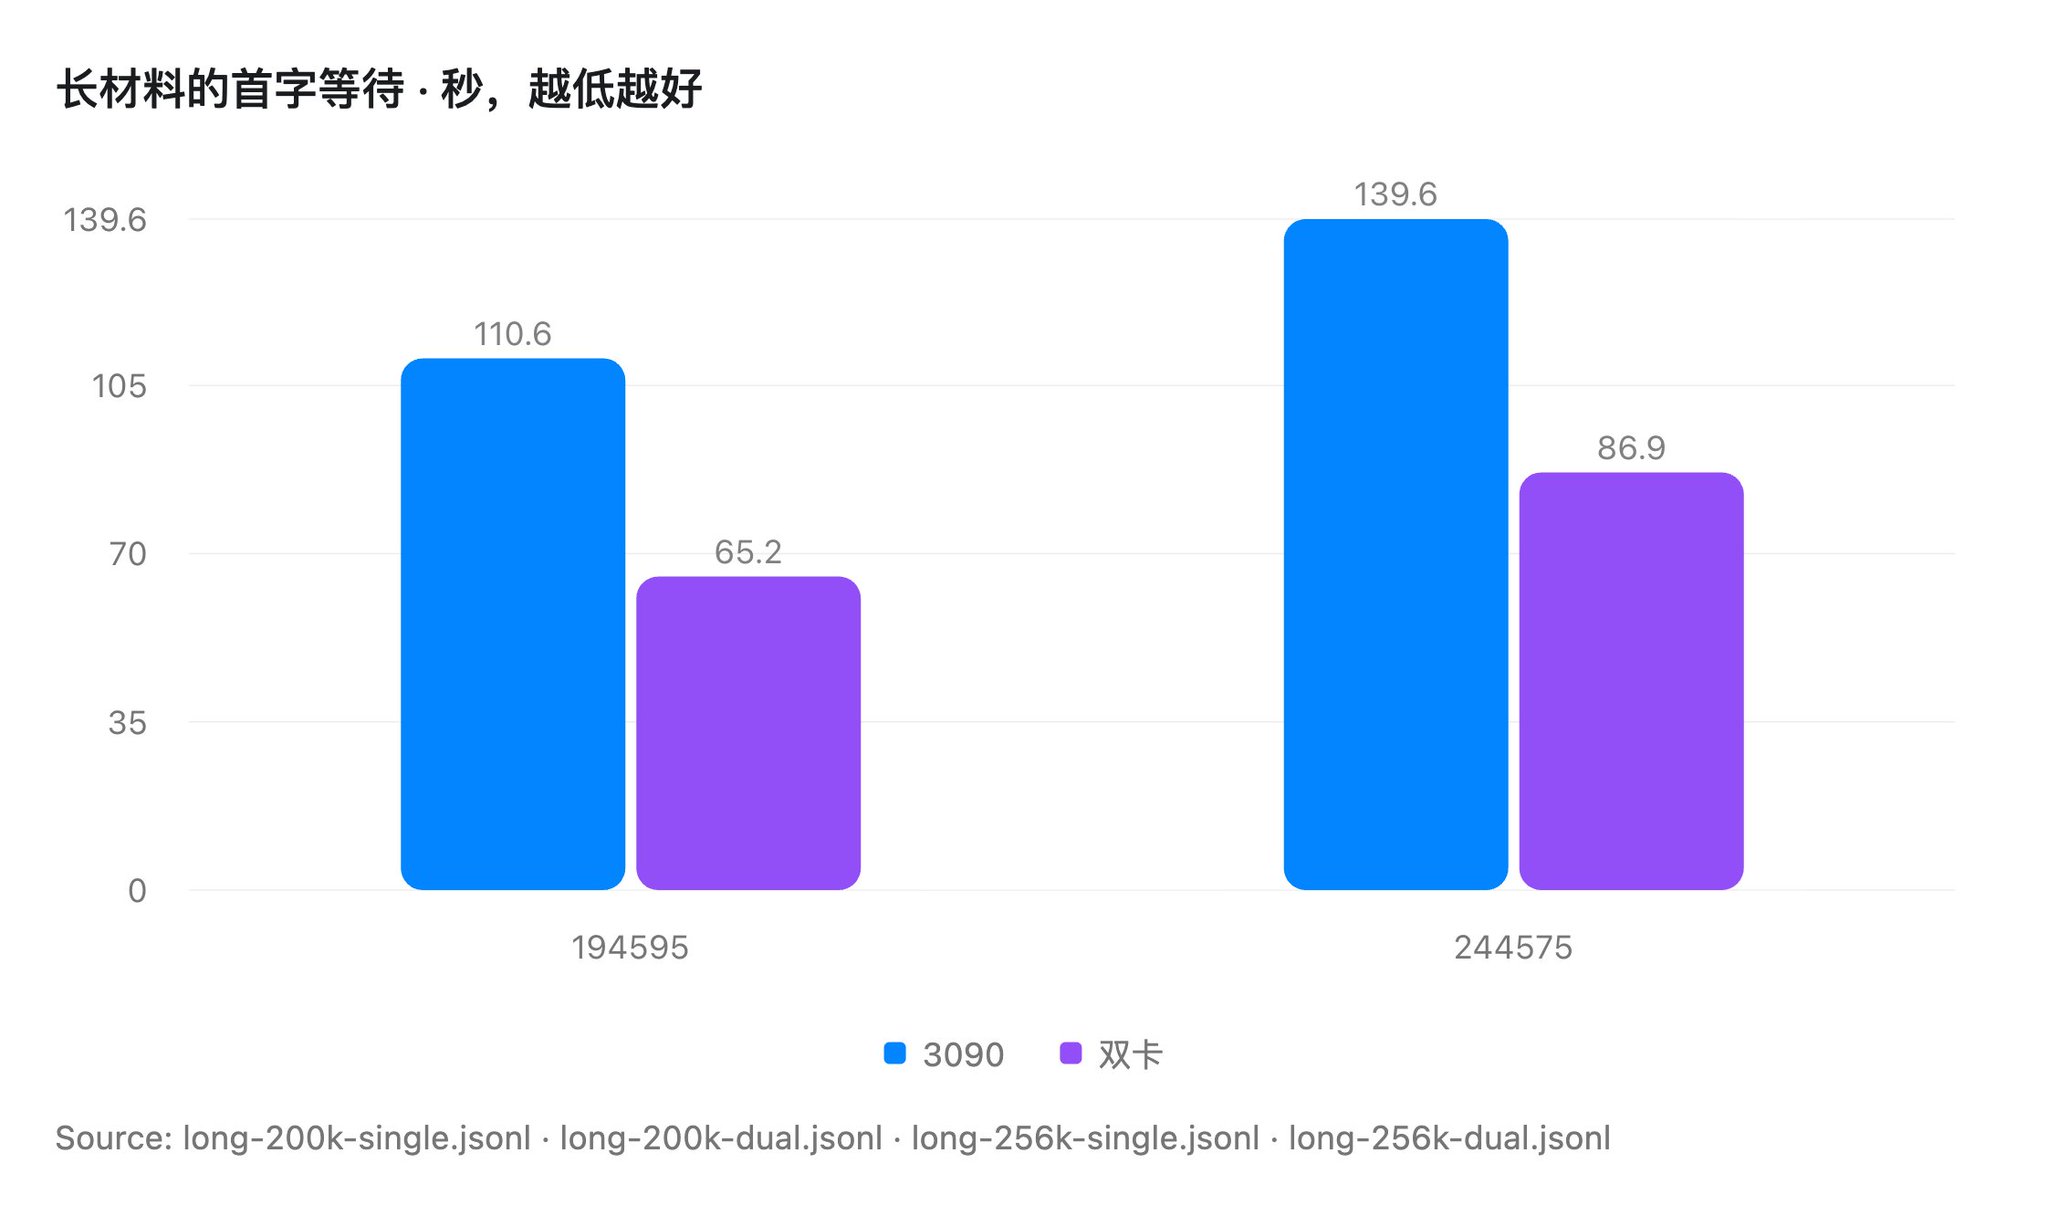
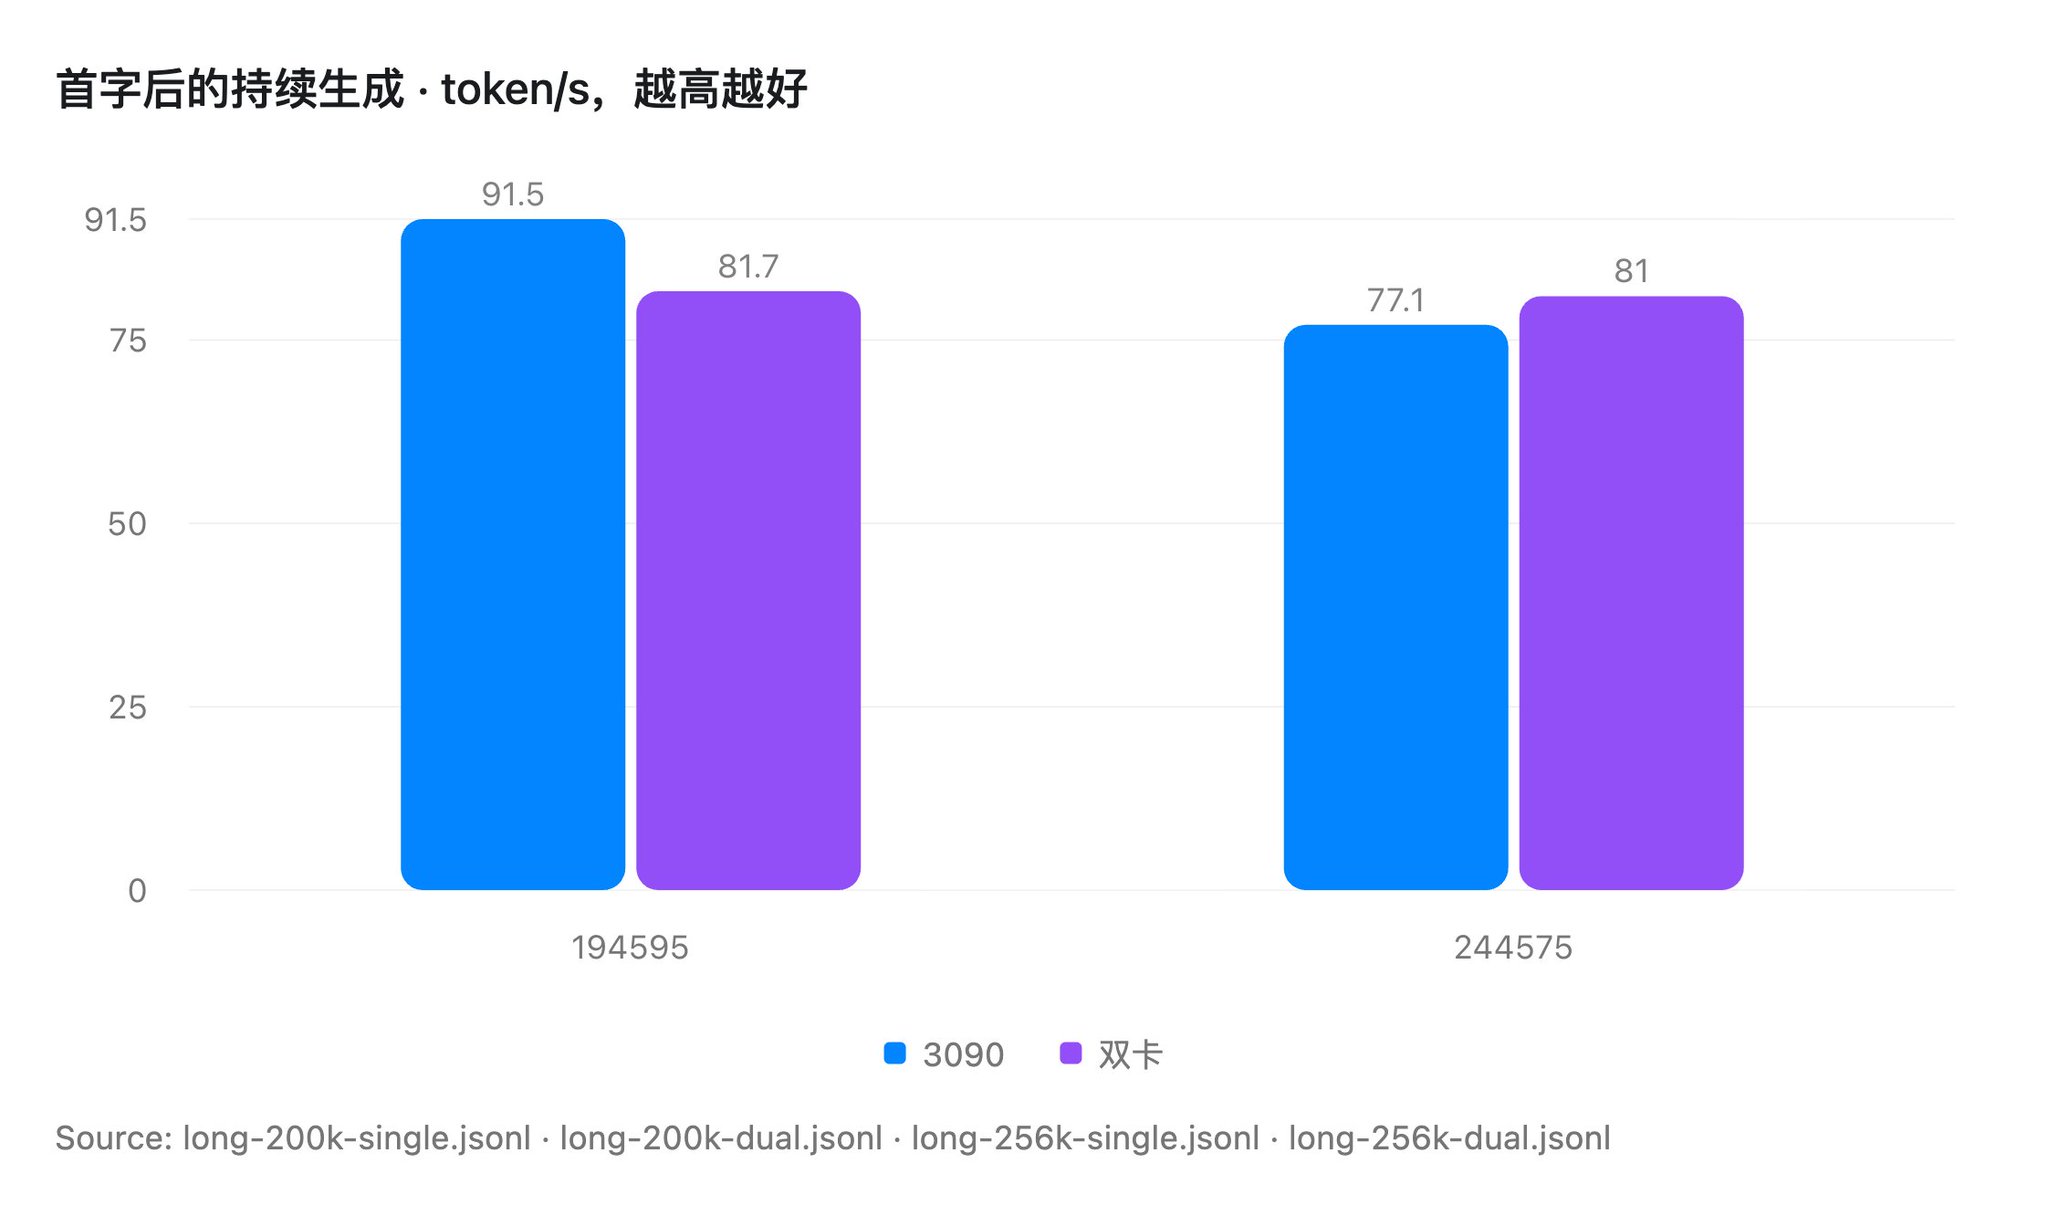
194,595 tokens 输入,首字等待从 110.6 秒降到 65.2 秒;244,575 tokens 输入,从 139.6 秒降到 86.9 秒。持续生成速度却没跟着涨:200K 档从 91.5 降到 81.7 token/s,256K 档 77.1 升到 81 token/s,和单卡接近。双卡不是全程加速开关,省的是读长材料的那段等待。
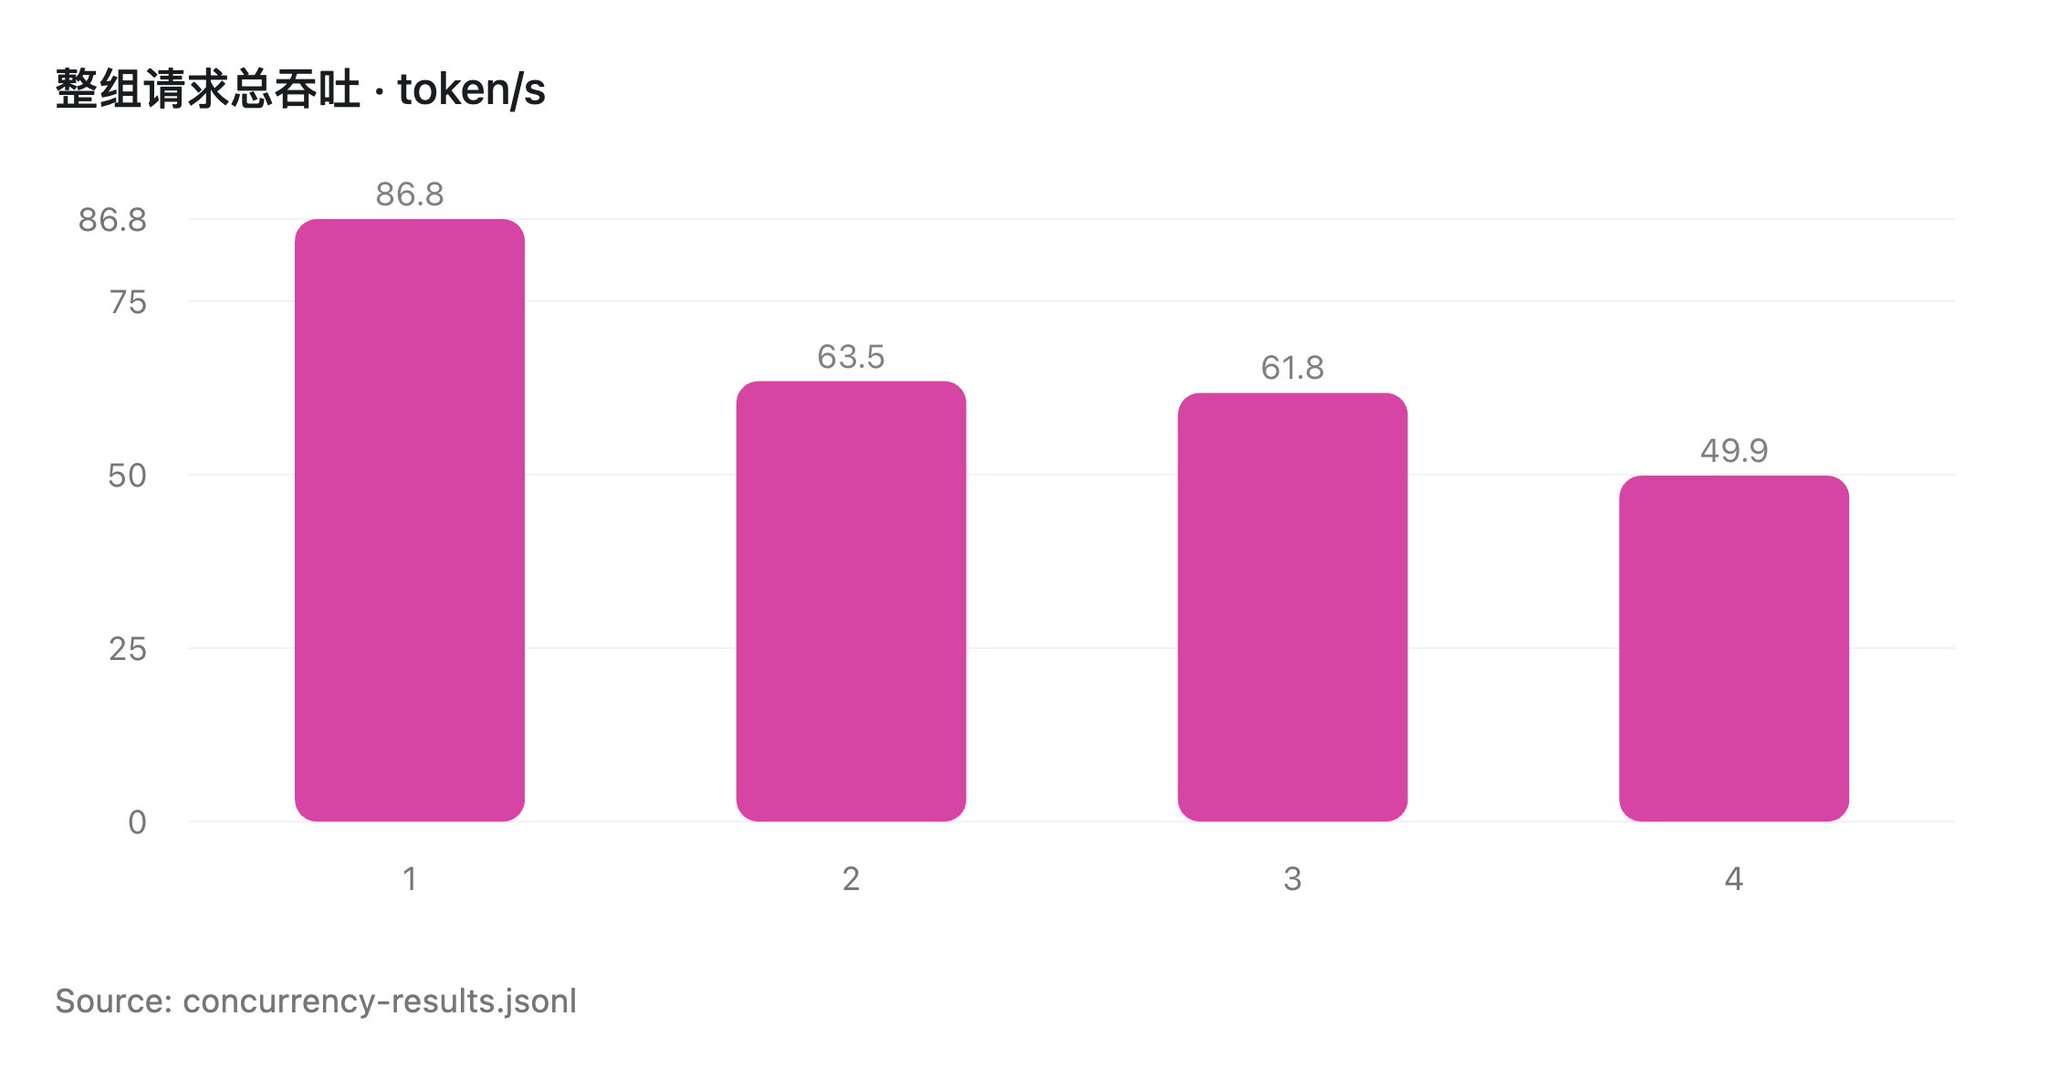
多路并发也一样:1、2、3、4 路总吞吐依次是 86.8、63.5、61.8、49.9 token/s,越并行越慢,最后选了一路。
Flash 对 27B:短输入 27B 快,长输入 Flash 赢
同条件补测,短输入下 27B 更快:1,872 tokens 输入,27B 首字 1.50 秒、118.58 token/s、总耗时 18.76 秒,Flash 是 4.23 秒、98.01 token/s、25.11 秒。输入拉长后反过来:31,878 tokens 输入,Flash 持续 92.63 token/s 低于 27B 的 104.61,但总耗时 Flash 38.15 秒、27B 49.61 秒;109,875 tokens 输入,Flash 首字 45.46 秒对 27B 的 137.87 秒,总耗时 69.06 秒对 162.81 秒。
质量:开思考都有收益,但别只看总分
12 道新题事先冻结提示、答案和评分规则,每题两轮。开思考后,Flash 去围栏匹配 15/16、代码 4/4、报告 6/6、运维 6/8;27B 是 14/16、代码 3/4、报告 6/6、运维 7.5/8。事后发现两道题本身有瑕疵,统一排除后:Flash 开思考 11/12,27B 开思考 12/12。探索题集里 Flash 从不开思考的 4/14 升到 high 档的 13/14,Luna high 是 12/14,一题之差不能证明全面胜出。
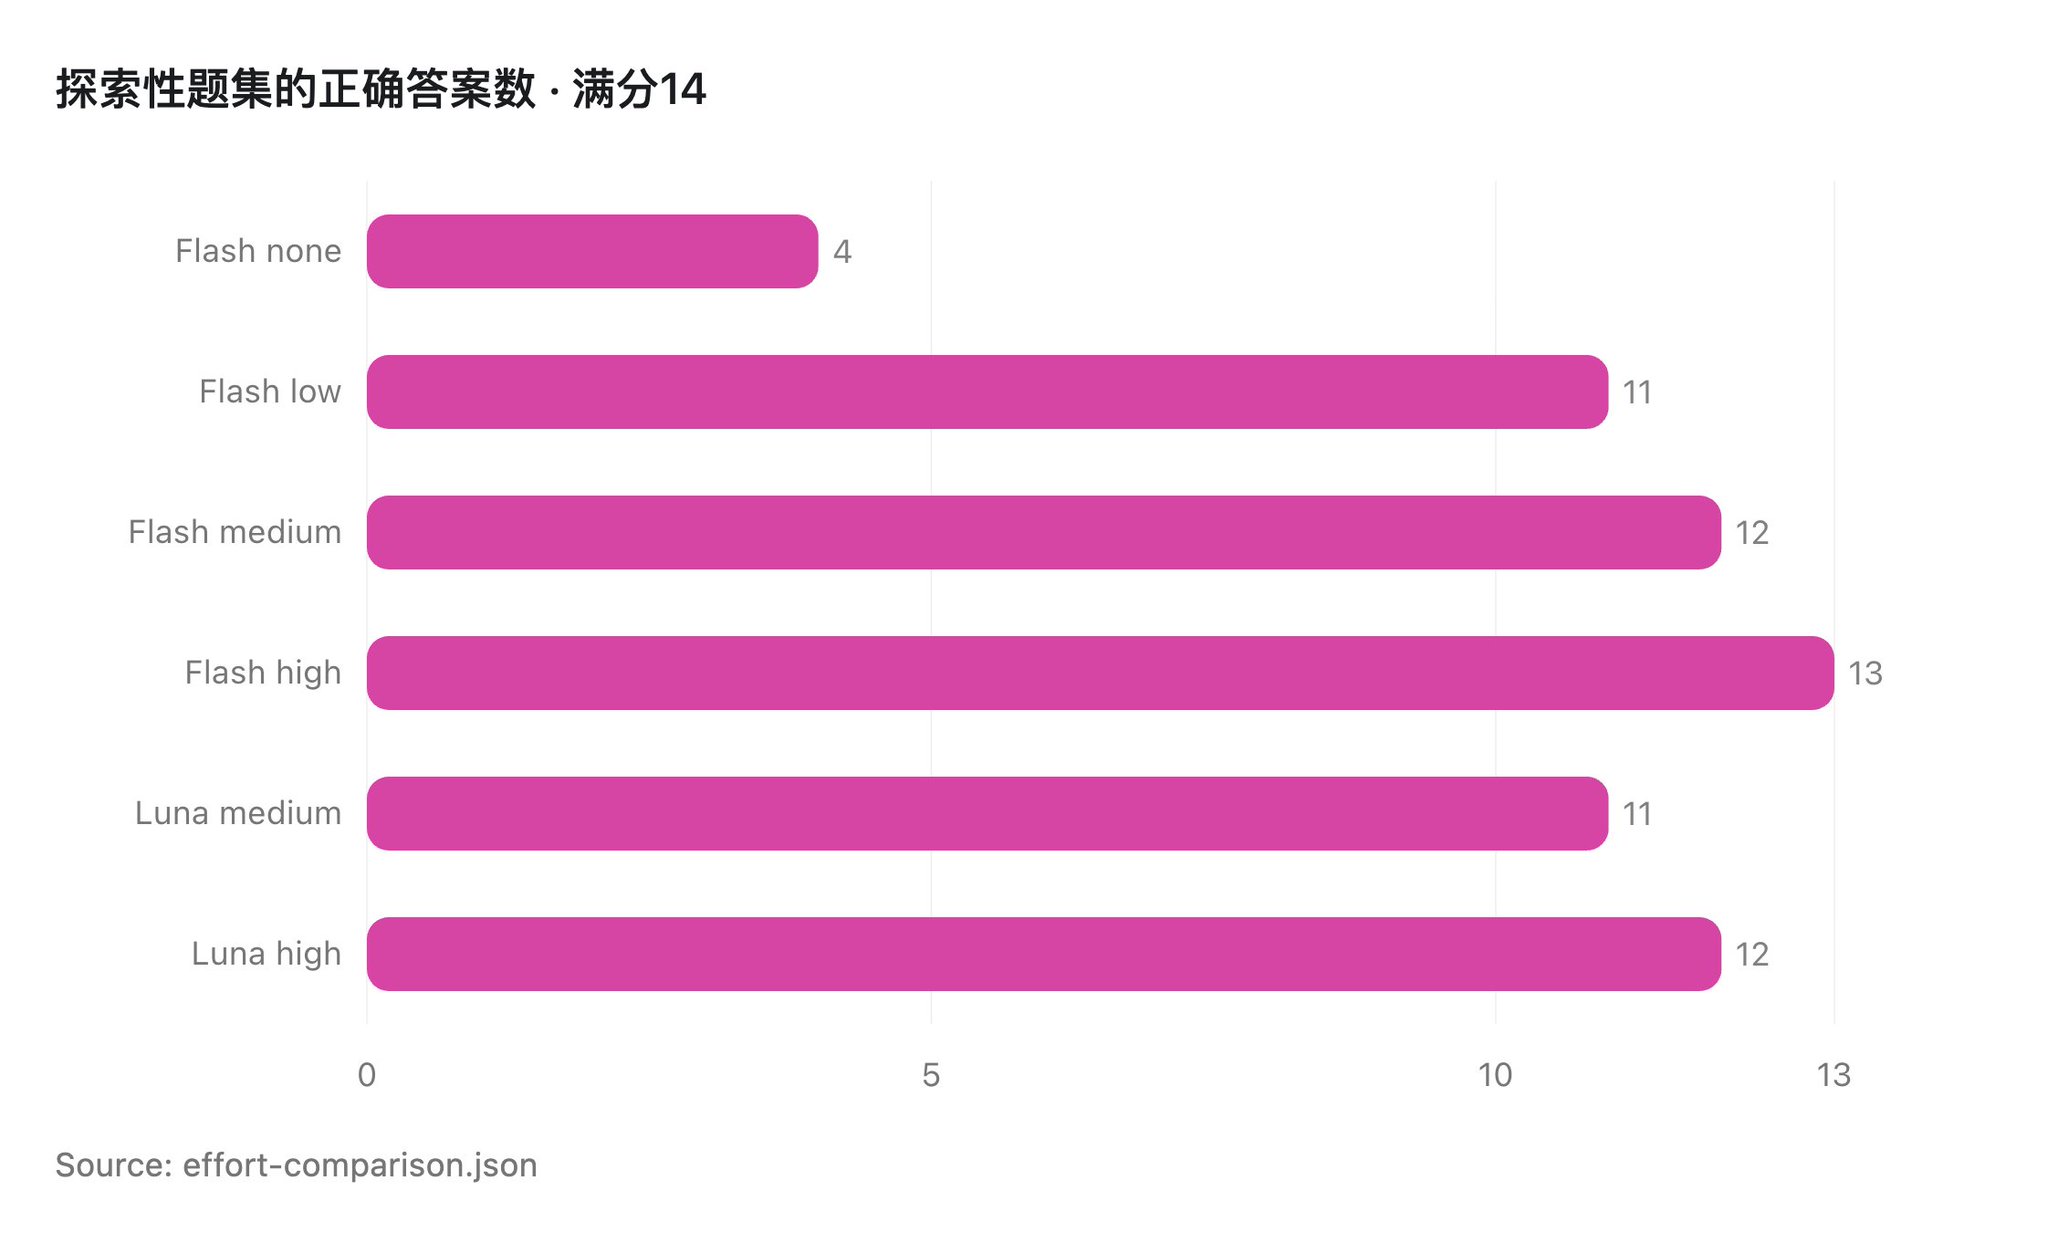
比总分更值得读的是失败:Flash 开思考第一轮排程题仍然答错,声称代价 111,重算实际是 80,最优值 65;27B 开思考的去重函数把内部保存的元组当最终记录返回。思考有收益,不等于每道题可靠,生成代码必须跑测试。
这篇报告没有证明什么
没有证明 256K 复杂全文理解——最长输入 244,575 tokens,检索通过的只是合成背景里的三处事实;没有证明 128K 连续输出质量;没有证明全天稳定;没有测量 IQ3 量化损失;没有测到硬件最大并发;没有可比的 Luna 速度;也没有 GPU 解锁收益——gpu-unlock 只做过源码审查和编译,没装模块。
日常服务现在是 OpenAI 兼容接口加基础工具调用,视觉放在 4060 Ti 上,只放行一路请求。作者保留了旧 27B 入口:双卡 Flash 最有依据的场景,是读长材料、答短问题;关键金额交给计算器或代码,部署方案和生成代码仍要验证。
链接:
Qwen 官方模型卡:https://huggingface.co/Qwen/Qwen3.8-Flash-Next
GSQ-RCO 量化:https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
Strata v0.2.4 发行页:https://github.com/Niko1221/Strata/releases/tag/v0.2.4