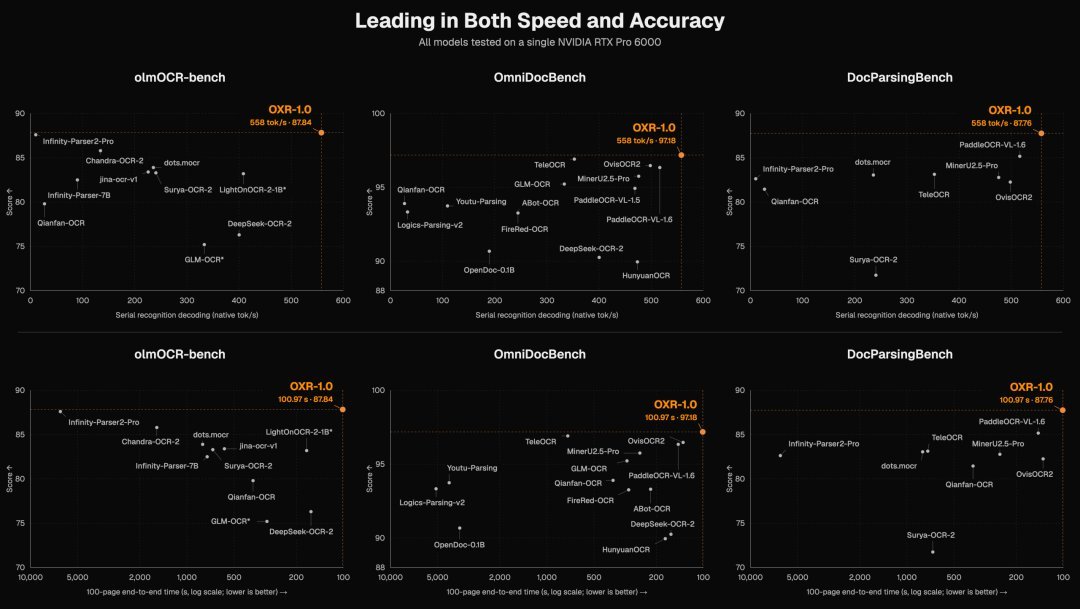
OCR 届又来了一个狠角色:国产开源文档解析模型 OXR,全称 Optical Everything Recognition,只有 1.3B 参数,在 OmniDocBench、olmOCR-Bench、DocParsingBench 三项基准里全部排到第一,速度和准确率同时登顶。
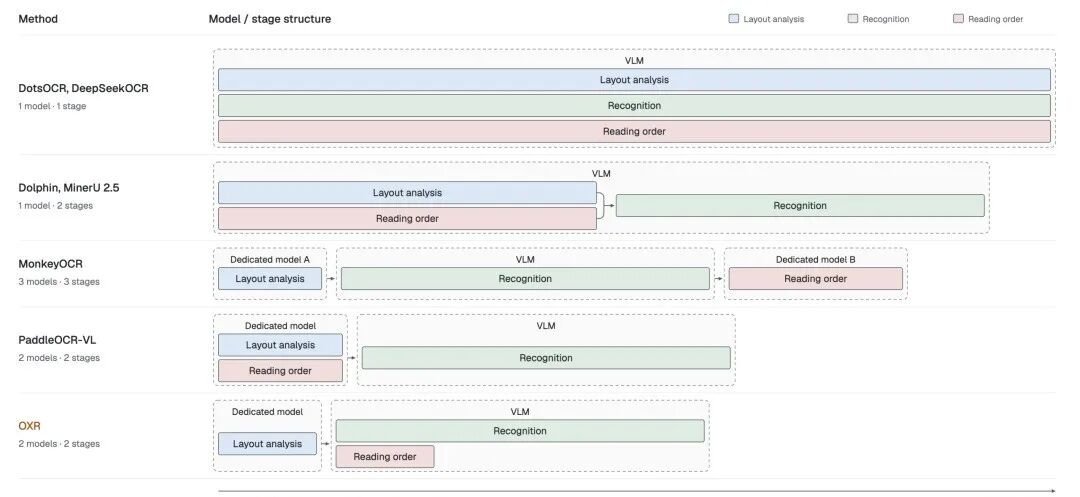
它覆盖文字、表格、公式、代码块等 13 类文档元素,版面分析模块可插拔。一般文档解析模型由三部分组成:版面分析、文本阅读顺序、文本识别。OXR 的改动是把阅读顺序(RO)从检测部分单独提出来,跟 VLM 放到一起:版面模型不再承担排序任务,更容易做轻量化,也更容易二次训练做定制;阅读顺序交给 VLM 处理,还能利用内容理解能力辅助判断顺序,复杂文档的解析效果更好。
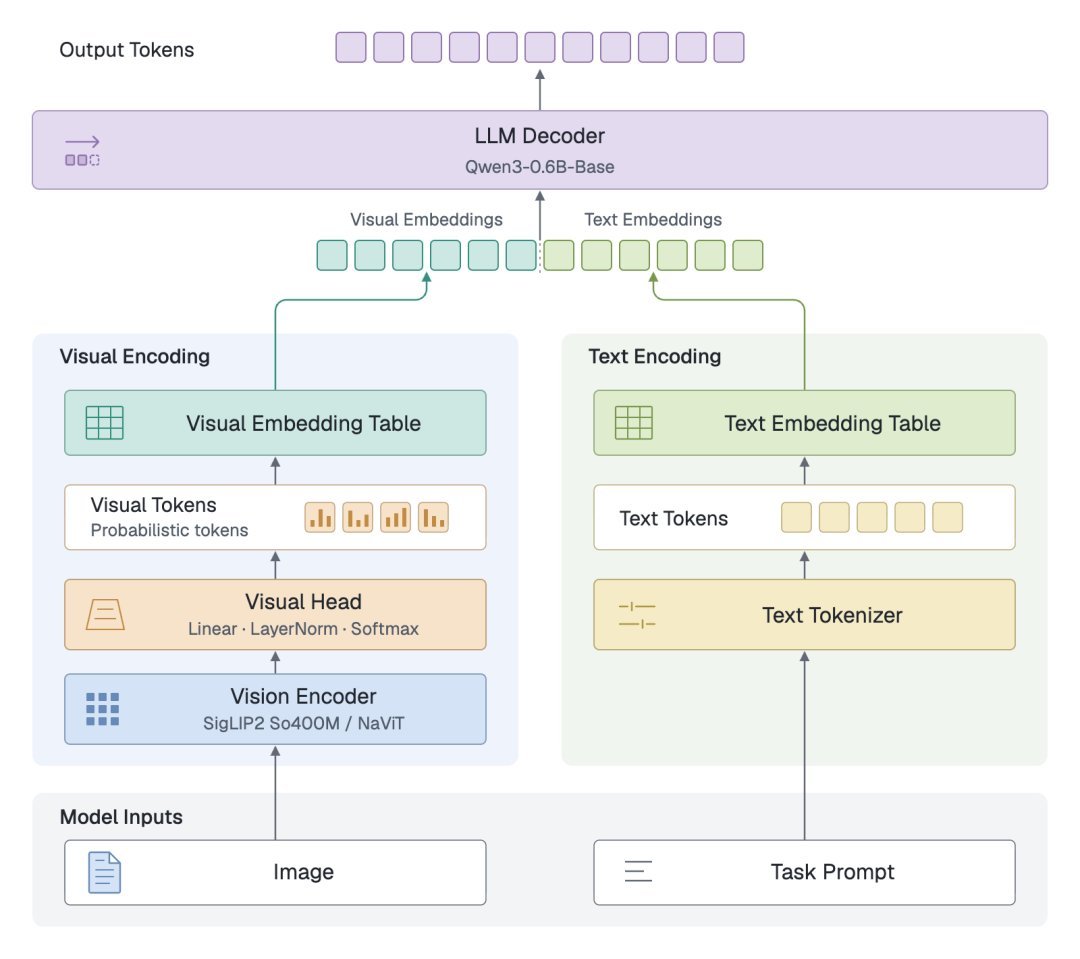
VLM 一侧,视觉编码器用 SigLIP2,大语言模型用 Qwen3-0.6B。
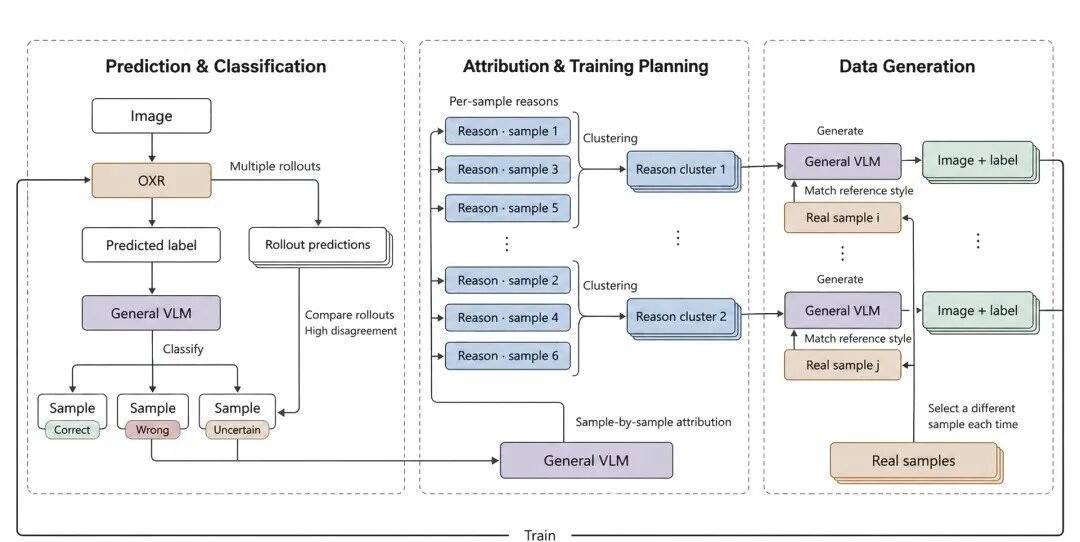
训练方法也有点意思:后训练用的是 RSI(递归自我改进)。先让 OXR 解析未标注文档,再结合通用多模态模型的评判和 OXR 的多次输出,找到错样本、弱样本,分析原因、聚类,制定下一轮训练策略和数据。数据生成每次都换不同的真实样本做版式和视觉风格参考,由通用多模态模型生成渲染代码,跑程序产出配套的图像与标签,同一种结构难点可以出现在不同样式里,减少合成数据反复用同一模板的问题。数据经过规范校验和筛选才进入下一轮训练,训完再让新版 OXR 重新处理上一轮判错的文档,依次循环迭代。
实测结果:在 24G 的 4090 上本地部署,同一份 17 页 PDF,OXR 的速度大概是 618 token/s,PaddleOCR-VL-1.6 大概是 527 token/s。行书或者楷体的手写体识别没问题,小孩写字也能认,但连笔非常多的情况,所有 OCR 都有问题。图表、甚至公式加无线框表格混合的复杂场景,识别结构和内容都做得不错,这一点比 Paddle 强。生僻字方面跟 Paddle 一样全军覆没,正确率很低。竖版识别会出现内容缺失。
已经开源,也能免费在线试用: