最近挖到个挺猛的开源声音复刻项目,叫 OmniVoice。丢一段参考音频进去,不用提前训练,就能生成接近原声音色的语音。
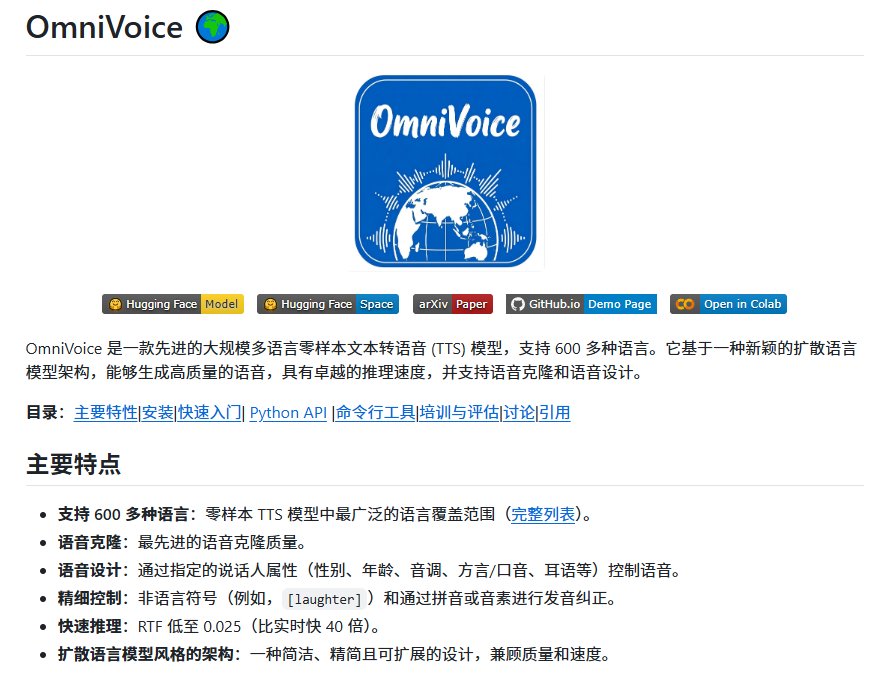
几个比较亮眼的点:600+ 种语言都支持;年龄、音高、方言、气声等特征可调;零样本声音复刻,拿来就能试;生成速度最高能到实时的 40 倍。
做配音、多语言内容,或者研究 TTS 的,都可以拿来玩玩。项目在 GitHub 上已有 1.5 万多星,Apache-2.0 开源协议。安装一条命令就行:pip install omnivoice;不想装也能直接上 HuggingFace Space 在线试,或者本地跑 omnivoice-demo 起个网页界面。
正文完