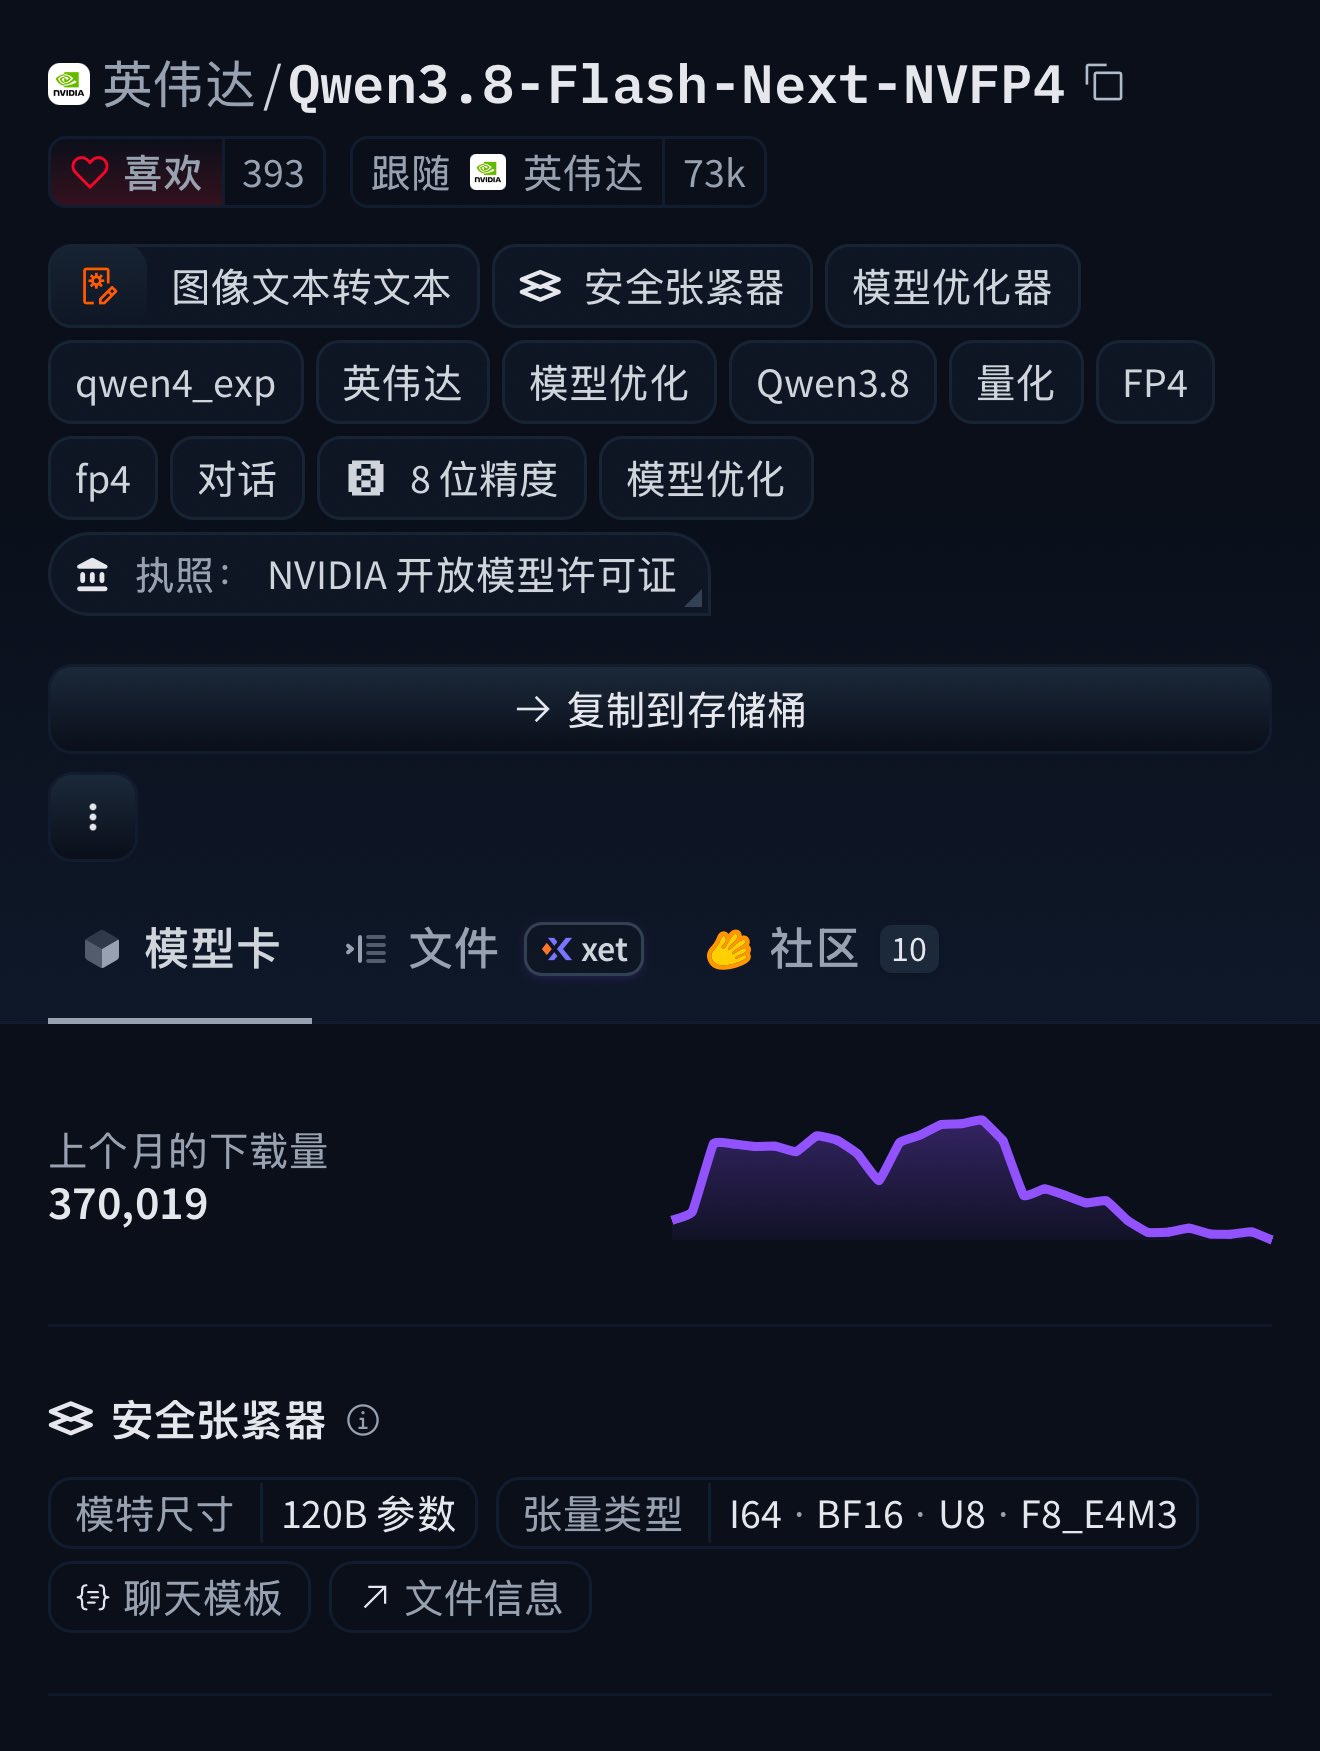
英伟达把 Qwen3.8-Flash-Next 做了 NVFP4 量化,体积直接砍到原来的 37%,精度几乎没掉。这是 Blackwell 时代真正能跑起来的实用级效率,上个月在 Hugging Face 上已经被下载了 37 万次。
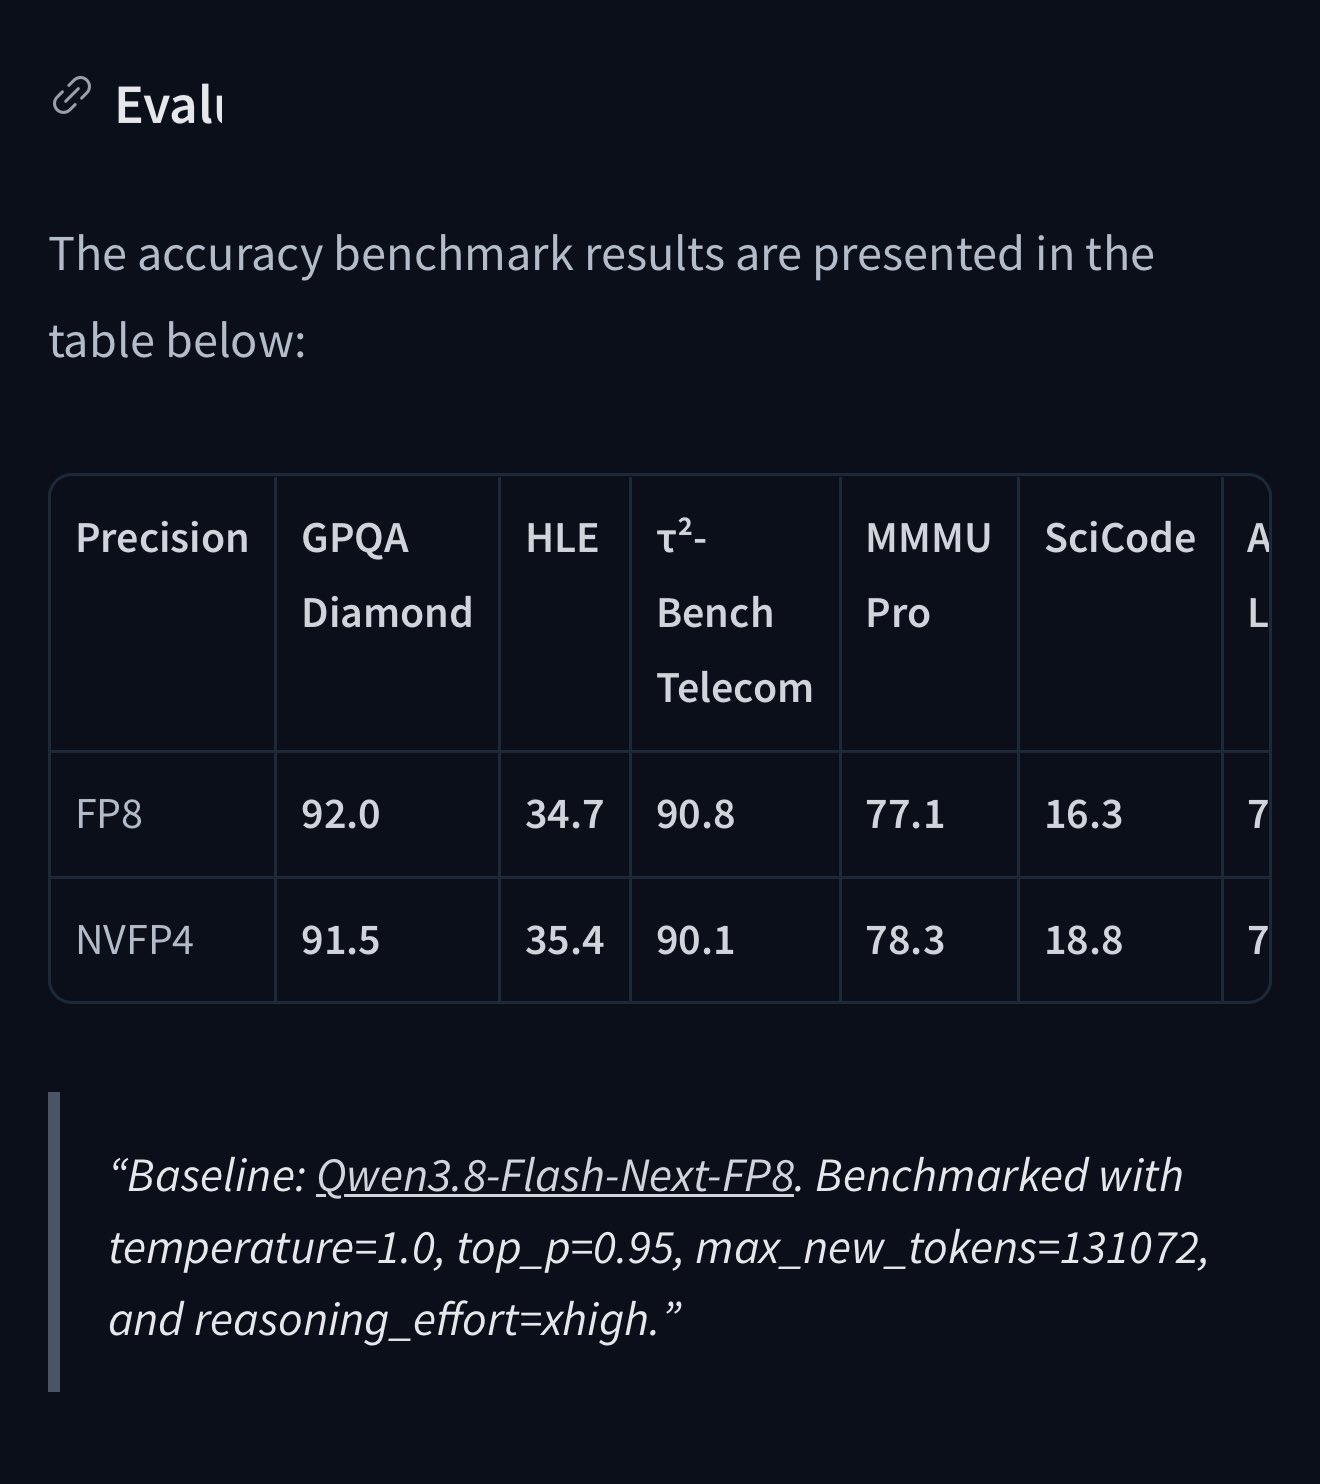
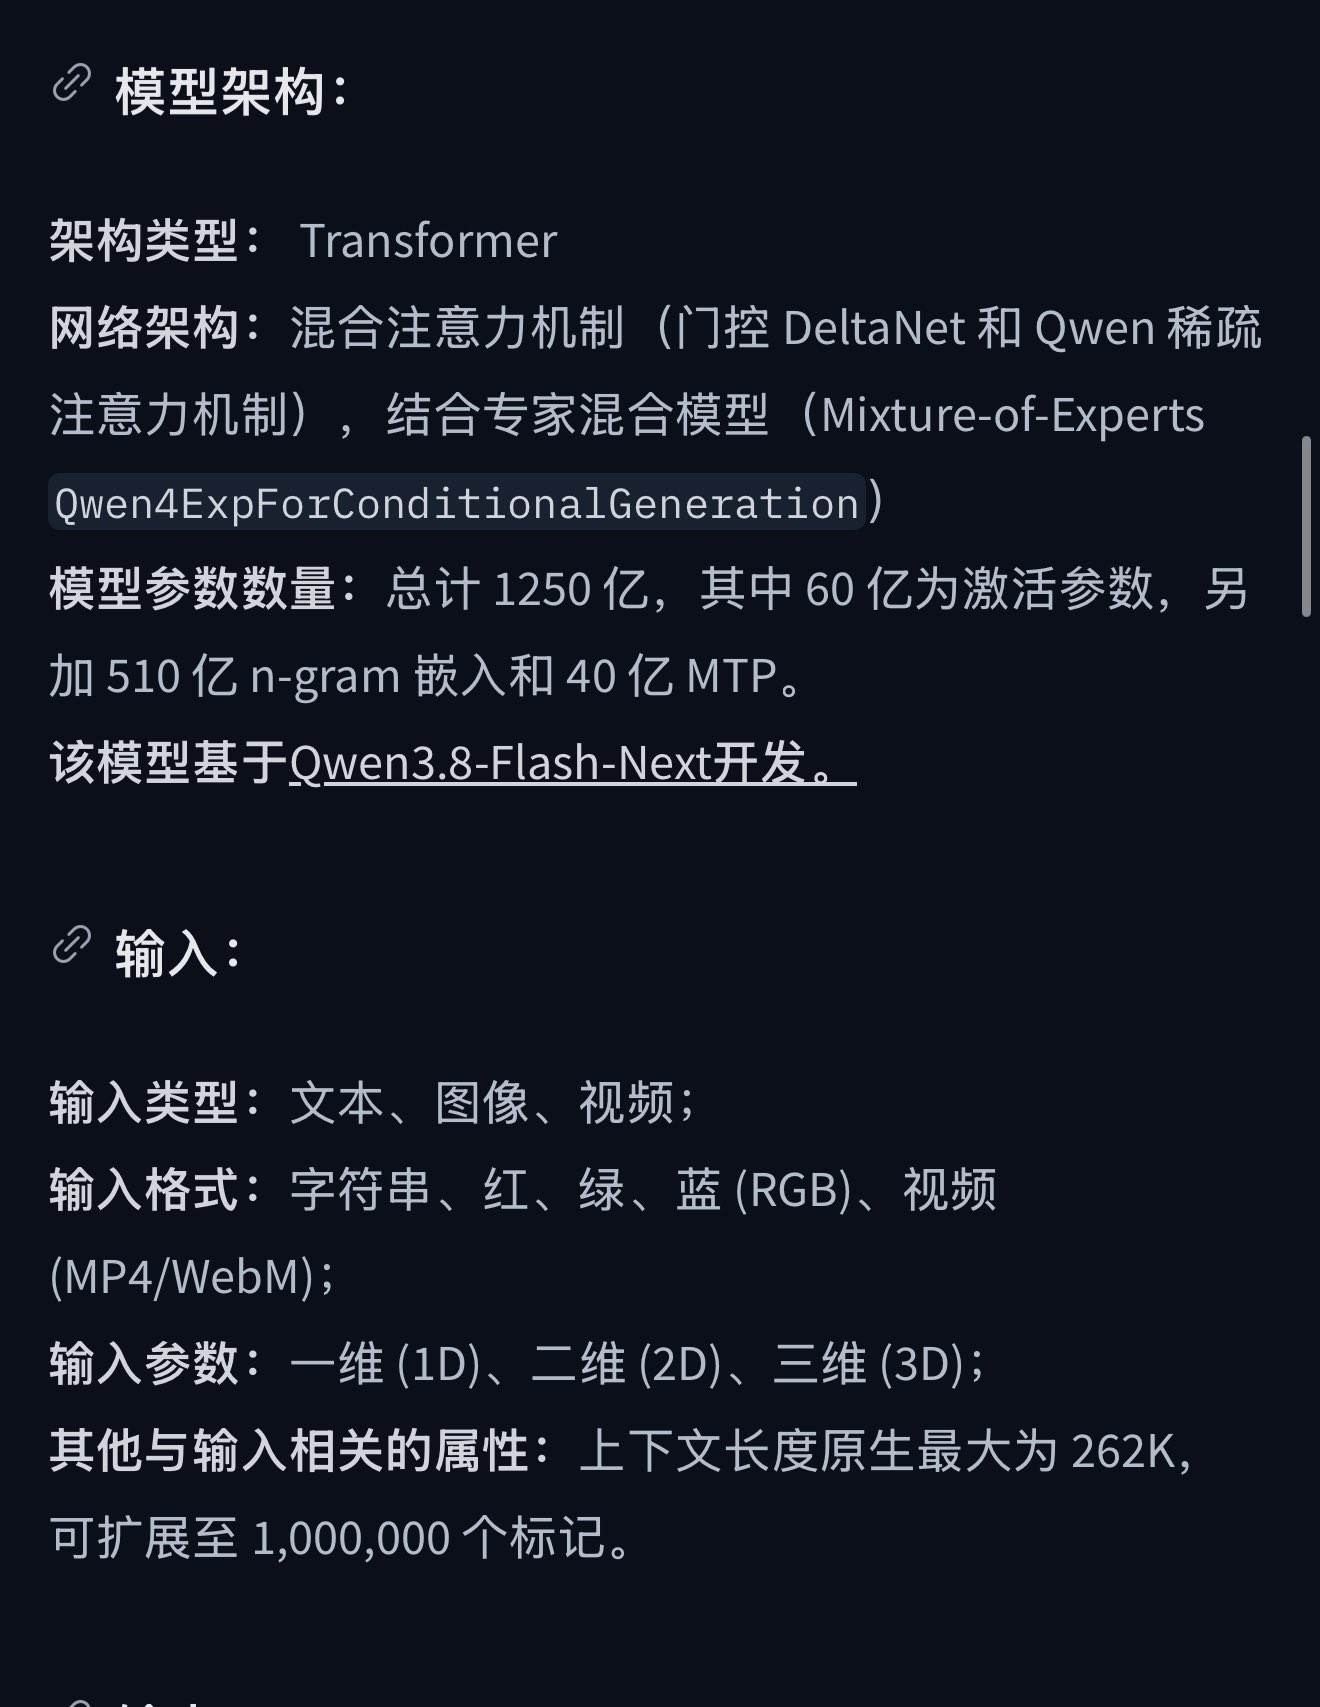
模型本身是 125B MoE:总参数 1250 亿,激活参数 60 亿,混合注意力(门控 DeltaNet + Qwen 稀疏注意力),再加 510 亿 N-gram Embedding 和 40 亿 MTP。原版 BF16 约 360GB,NVFP4 版小了约 2.7 倍。实测精度对比,FP8 和 NVFP4 两档:GPQA Diamond 92.0→91.5,HLE 34.7→35.4,MMMU Pro 77.1→78.3,SciCode 16.3→18.8,有升有降,基本没掉。
性能上,在 SWE-bench Pro、CoWorkBench、JobBench 这些真实任务上,它比 Claude Opus 4.6 Max 更好。原生 262K 上下文,可扩展到 1M,文本、图像、视频多模态都支持。路由专家用 NVFP4,关键层保留 BF16/FP8 混合精度,精度损失压得很低。
想自己跑,硬件推荐 NVIDIA Blackwell(B200/B300),Linux 环境。先拉模型:huggingface-cli download nvidia/Qwen3.8-Flash-Next-NVFP4,再装较新 commit 的 vLLM 和 Transformers ≥ 5.16.0,启动命令:vllm serve nvidia/Qwen3.8-Flash-Next-NVFP4 –tensor-parallel-size 8 –quantization modelopt –max-model-len 262144 –reasoning-parser qwen3 –trust-remote-code。想再快一点,可以开 MTP 投机解码。
原模型:https://huggingface.co/Qwen/Qwen3.8-Flash-Next
NVFP4 版:https://huggingface.co/nvidia/Qwen3.8-Flash-Next-NVFP4