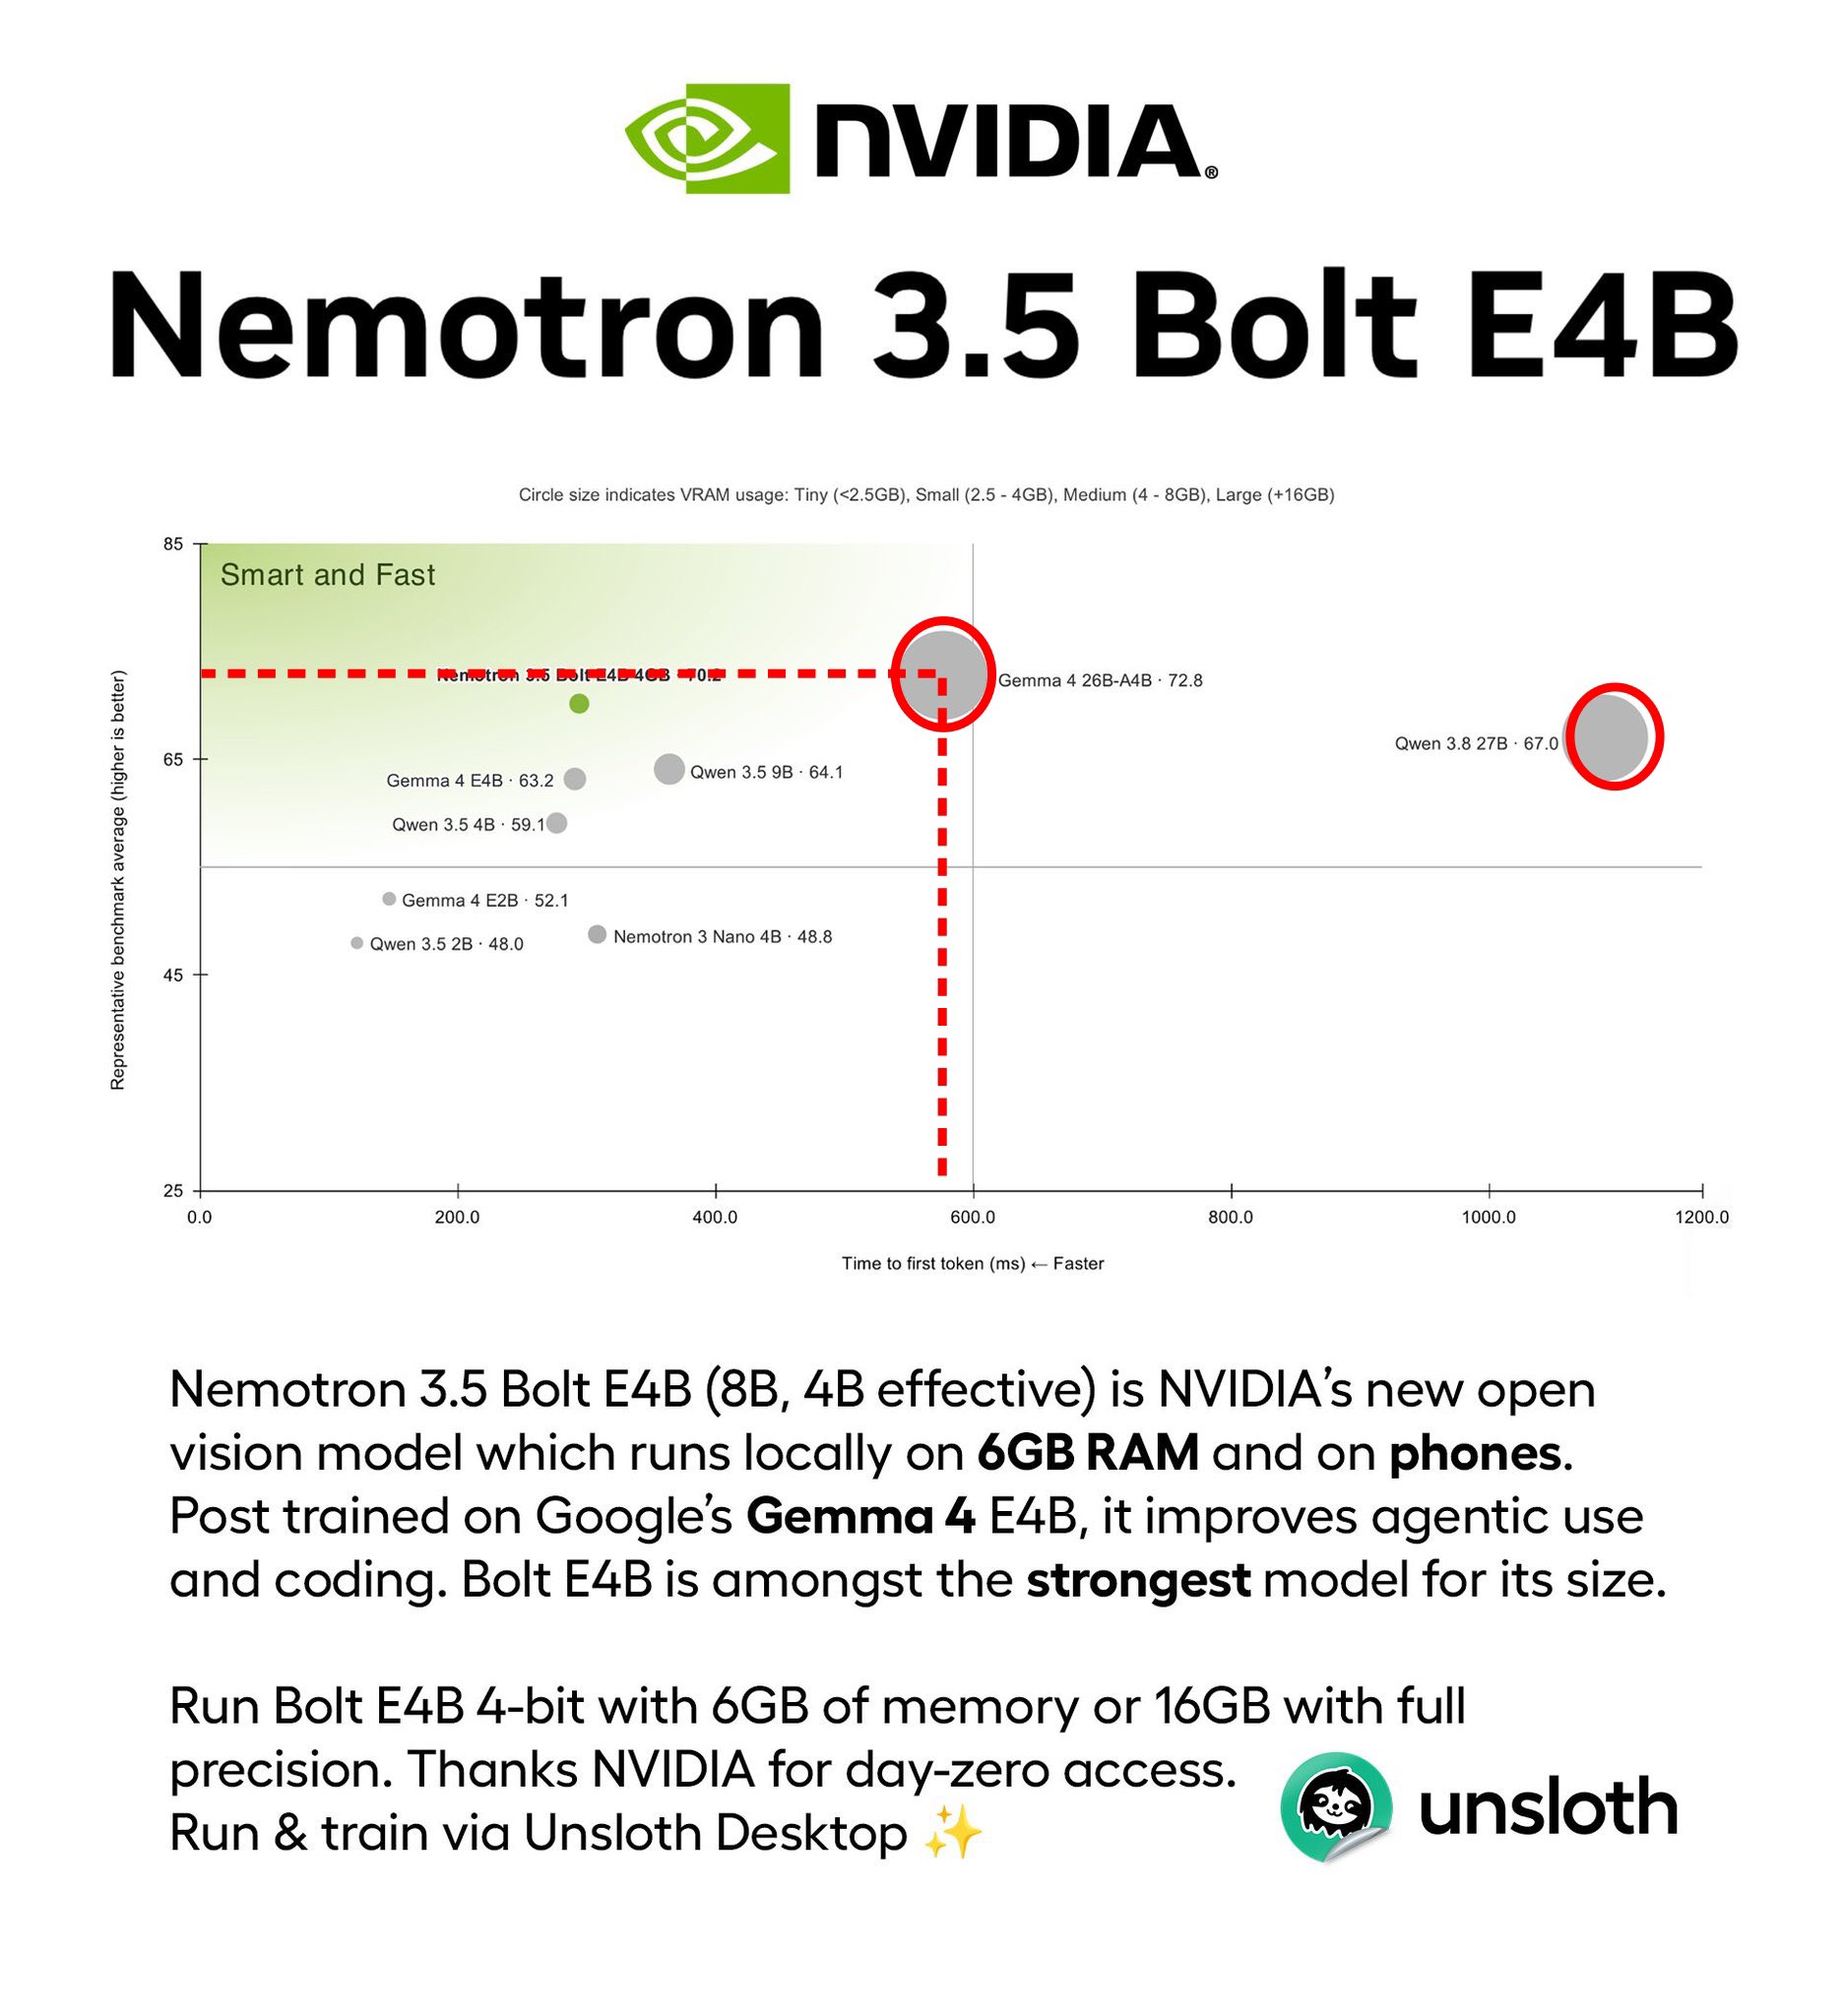
手机也能跑本地 AI 模型了,而且只要 6GB 内存。英伟达刚刚开源了新小模型 Nemotron-3.5-Bolt-E4B,直接把本地隐私 AI 下放到手机和边缘设备上。
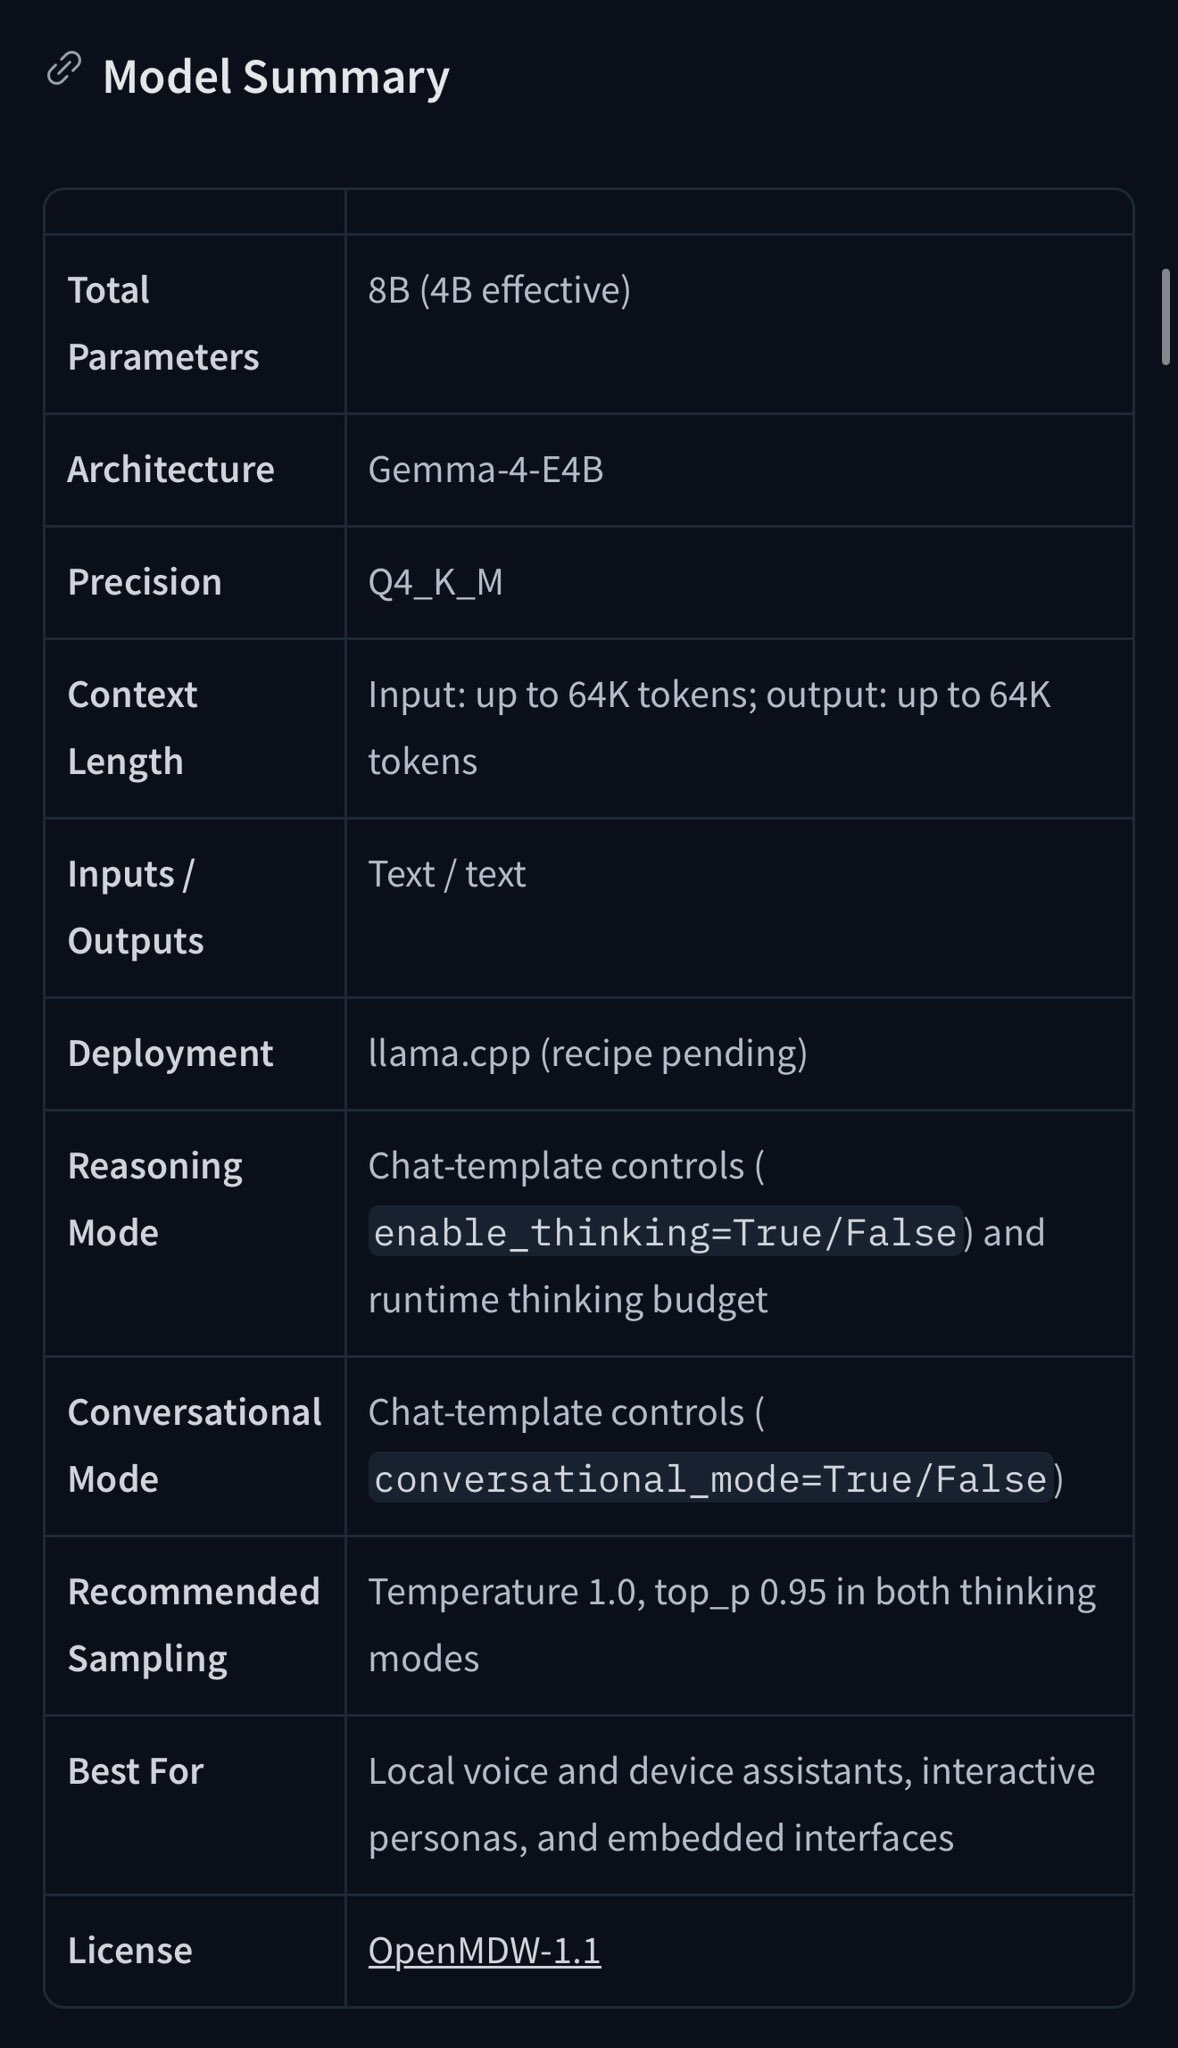
这个模型基于 Gemma 4 E4B 后训练,官方给出的参数是 8B、有效约 4B。核心亮点有四点:
- 仅 6GB 内存本地运行,手机和平板也能玩,不再需要高端显卡;
- 64K 上下文 + 多轮工具调用,支持可配置的推理 / 对话模式;
- 输出 token 比同类模型少约 80%,响应更快,对话质量反而显著提升;
- 开源(OpenMDW-1.1),GGUF 量化版即开即用。
快速上手也很直接:先从 HuggingFace 下载 GGUF 文件——官方版在这里:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB
想要开箱优化版的可以用 Unsloth 版:
https://huggingface.co/unsloth/NVIDIA-Nemotron-3.5-Bolt-E4B-GGUF
然后直接 ollama run nemotron-3.5-bolt:e4b 启动,llama.cpp、LM Studio、Unsloth Desktop 都能加载。推荐参数:temperature 1.0 + top_p 0.95,推理模式可按需开关。如果是低内存设备,建议先从 4K–8K 上下文起步再往上加。
官方还给了完整指南和详细规格说明:
- 部署指南:https://unsloth.ai/docs/models/nemotron-3.5-bolt
- 官方详情:https://research.nvidia.com/labs/nemotron/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB/
英伟达官方说这个模型是给本地助手、交互角色和机器人用的,能持续对话、能调用工具干活。手里有能跑起来的设备,今晚就可以试一轮了。
正文完