同样开长上下文,33B 和 27B,显存为什么能差十几 GB?作者把 Nanbeige4.3-33B 和 Qwen3.8-27B 的性能跟效果都测了一遍,又去翻了配置,算明白了。
测试条件是单张 48GB RTX 4090,单路、128K 容量、8bit KV,全程裸跑,没开投机解码。
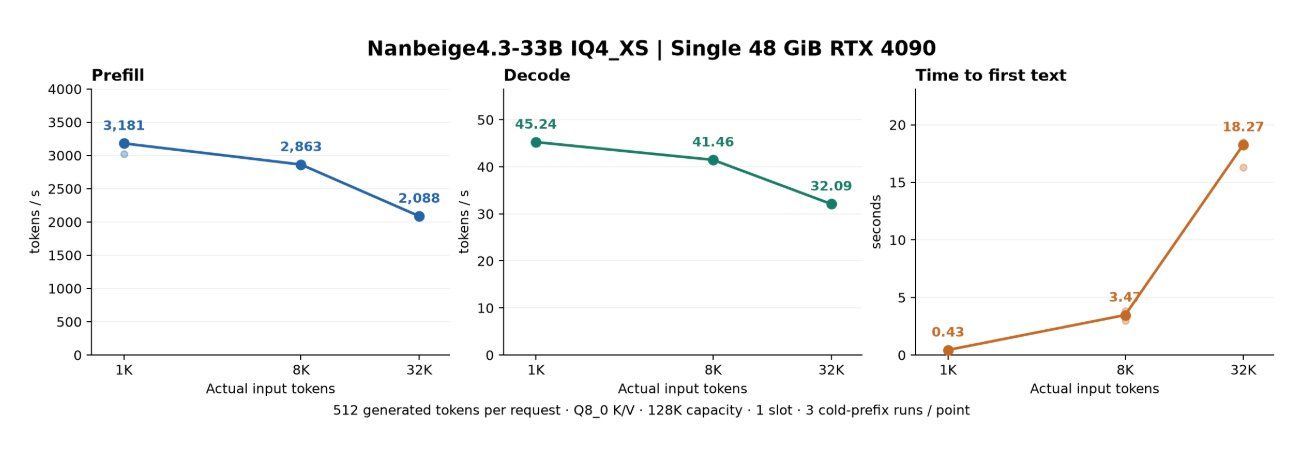
显存上,Nanbeige 33B(IQ4_XS)占 31.1 GiB,Qwen 27B(EXL3 3.5bpw)只占 17.6 GiB。速度上,Nanbeige 在 1K 输入时 45 tok/s,32K 输入时 32 tok/s;Qwen 干活时平均生成速度快 60% 以上。
效果上,3 个 30 分钟真实 Coding Agent 任务(Flask / HTTPX / pytest),Nanbeige 完成 1 个,Qwen 完成 2 个。同一个 Flask bug,Qwen 3 分半修完,Nanbeige 磨了 10 分半。
显存差距的一大来源是注意力架构:Nanbeige 52 层全部使用全注意力,Qwen 是 16 层全注意力加 48 层线性注意力。全注意力需要为历史 token 保存 KV,线性注意力层主要维护压缩状态,上下文越长,这笔缓存账越明显。
只算 8bit KV 数据本体,理论上 128K 上下文 Nanbeige 约 13 GiB,Qwen 约 4 GiB;256K 时分别是约 26 GiB 和约 8 GiB。Nanbeige 的 256K KV 算上缩放开销约 27.6 GiB,再加约 16.8 GiB 权重,两项已经 44.4 GiB,加上运行缓冲,总占用可能到 45 GiB 左右,48GB 卡基本顶满;Qwen 这套部署粗估约 22 GiB。
官方跑分上,Nanbeige 的纸面成绩确实更强:Terminal-Bench 2.1 是 80.9 对 73.0,DeepSWE 是 65.5 对 42.5,Automation Bench 是 54.2 对 38.3。
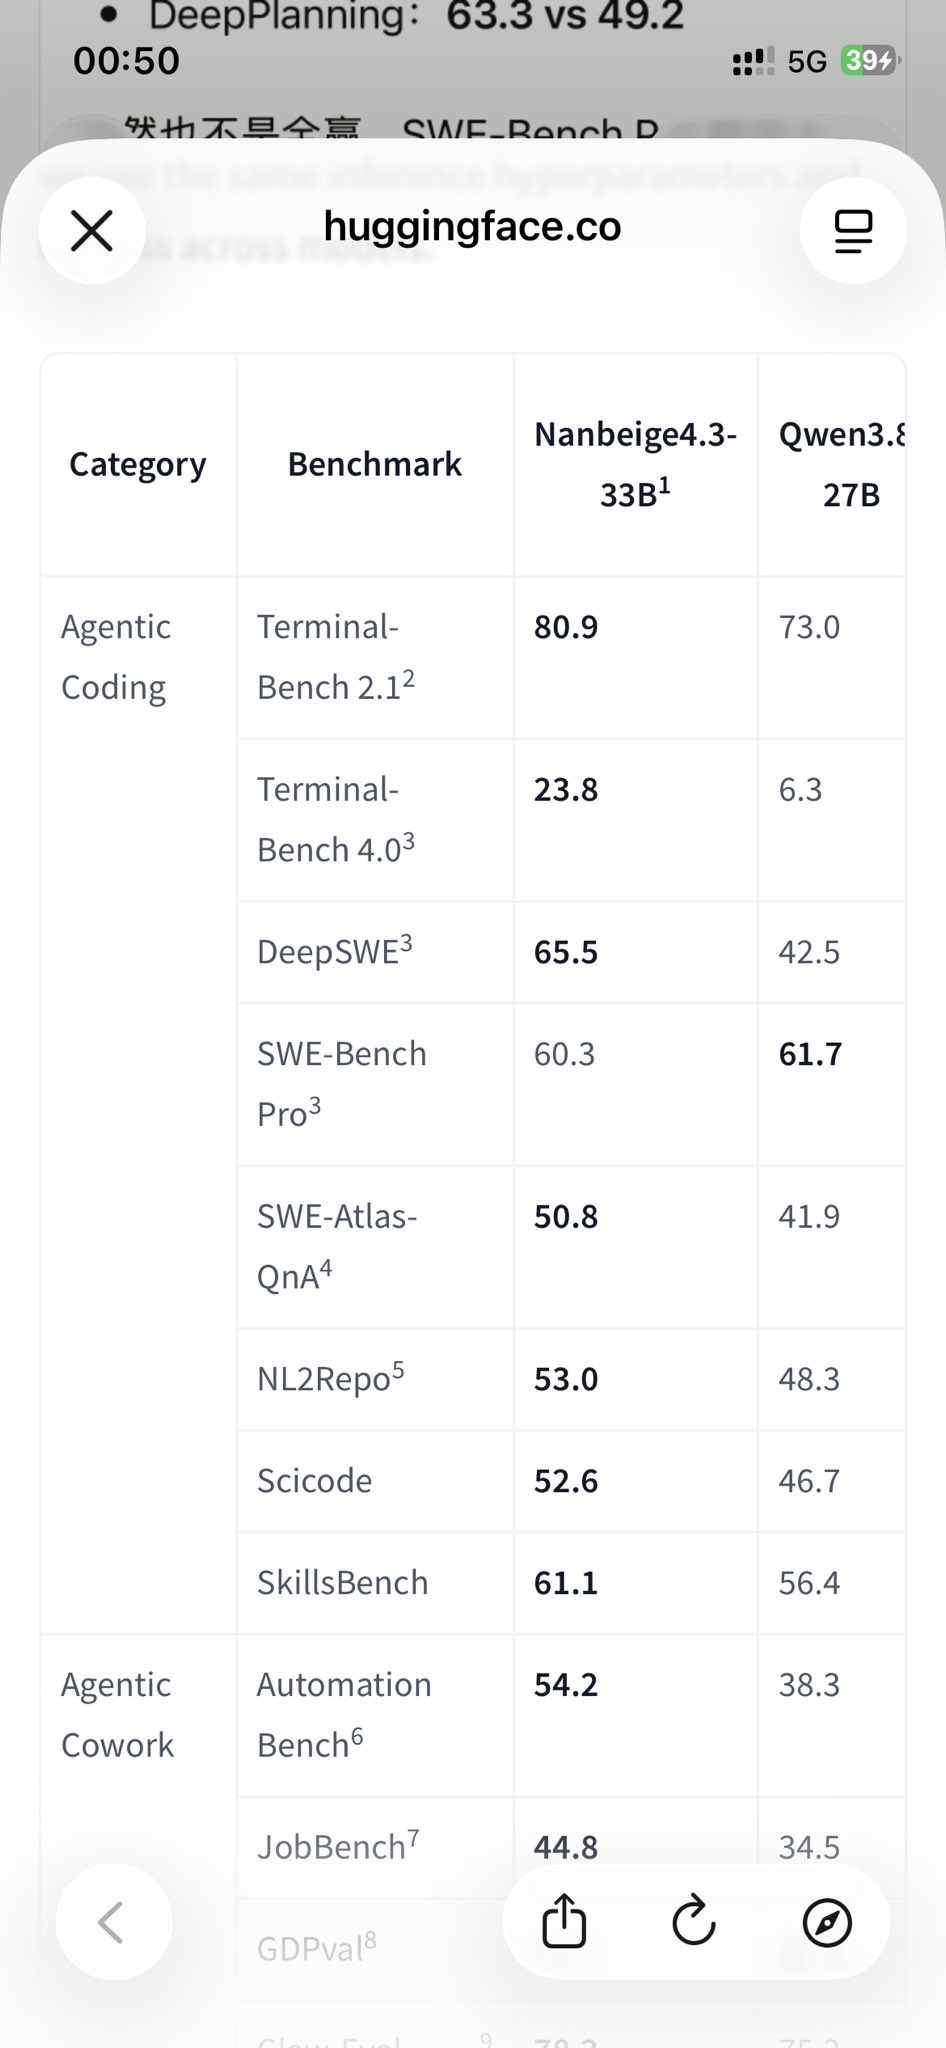
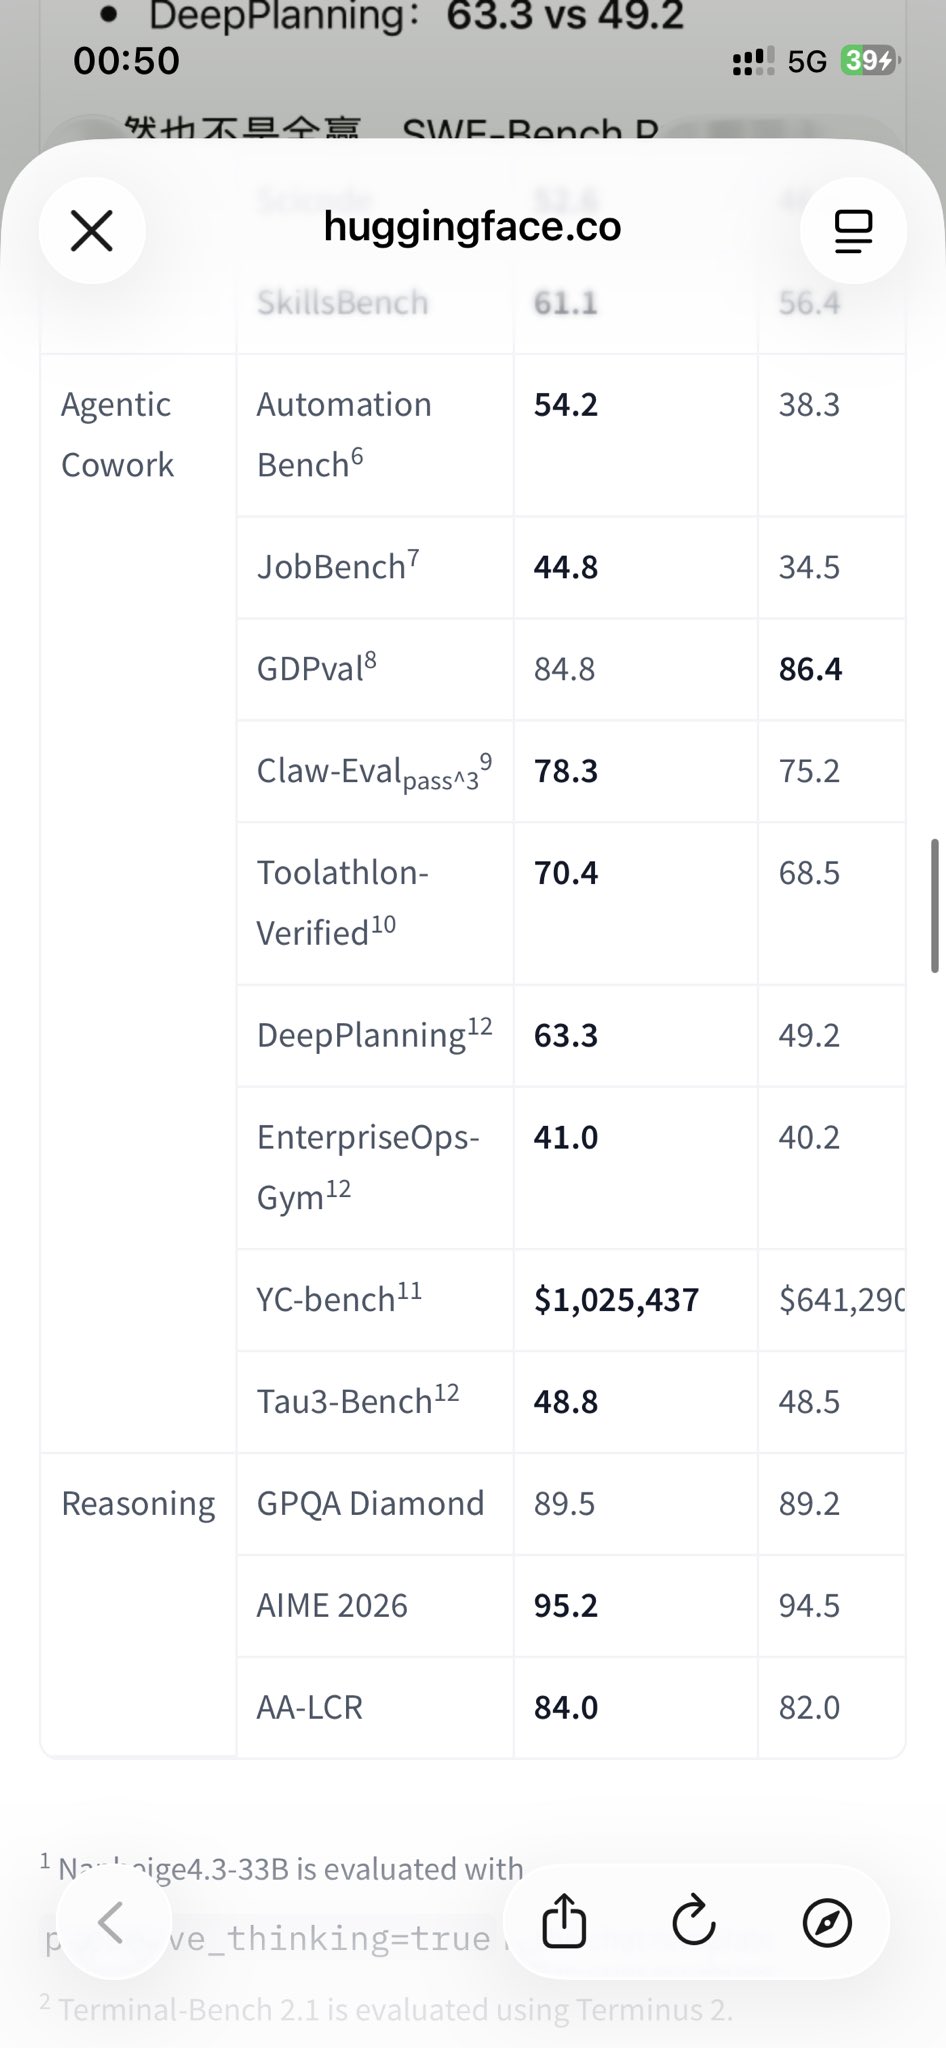
作者的结论是:Nanbeige 全注意力架构跑超长上下文,成本确实更高,自己的 48G 卡也顶不住。对单卡跑长上下文 Agent 的用途,目前兼顾智力和速度的,就是 Qwen Next Flash iQ4。另外提醒一句,256K 的数字是推算,尚未实测;两边后端和量化不同,这是两套量化的对比。