小红书、抖音、视频号、微博的数据采回来,文字、图片、音频、视频混在一起,同一款产品还有全名、简称、系列名和用户自己的叫法。只要其中一环处理错了,后面的洞察和报告结论都会跟着跑偏。想把这堆数据变成可信的分析底座,可以按下面这套八步链路走,消费品洞察、汽车口碑、餐饮选址、旅游评价、品牌舆情都能套用。
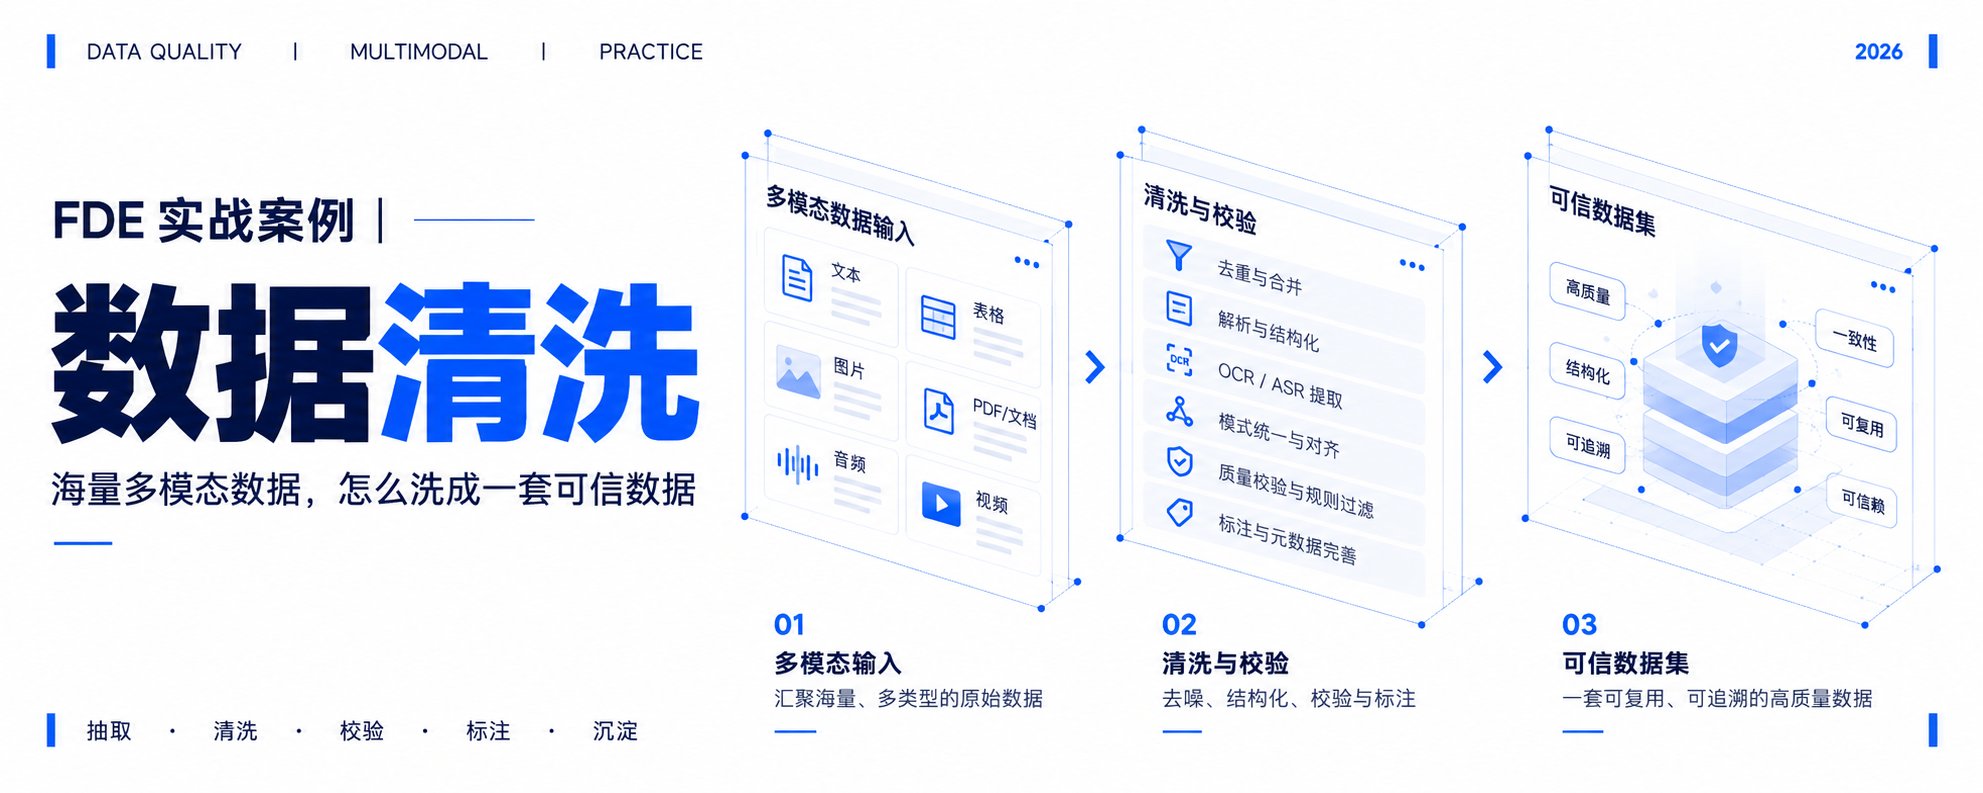
第一步先定数据规范:这批数据最后拿来干什么,字段、关系、证据和入库条件就按这个写。同一条种草素材被十个账号发,传播复盘要保留十次发布,统计自然讨论时又要标成同一组重复内容——采集时直接删掉九条,后面就换不了统计口径。
第二步,原始内容永远保留。原文、图片、音频、视频、链接、发布时间和平台原始 ID 都留着,清洗后的文字单独存,不能覆盖原文。OCR、ASR 和模型标签只做新增结果,这样识别错了能回溯,换了模型能重跑,报告结论也能找到证据。
第三步梳理关系。只存作者、正文、时间和互动量,做词频够用,分析评论就会丢上下文。一条“这个也太差了”到底在评原帖还是回上一条评论,得看它挂在哪个 ID 下面。平台内至少保留 user_id、post_id、comment_id、parent_comment_id,主键用“平台名 + 平台原始 ID”,避免跨平台编号撞车;跨平台别直接认人,昵称、头像相同只能当线索。
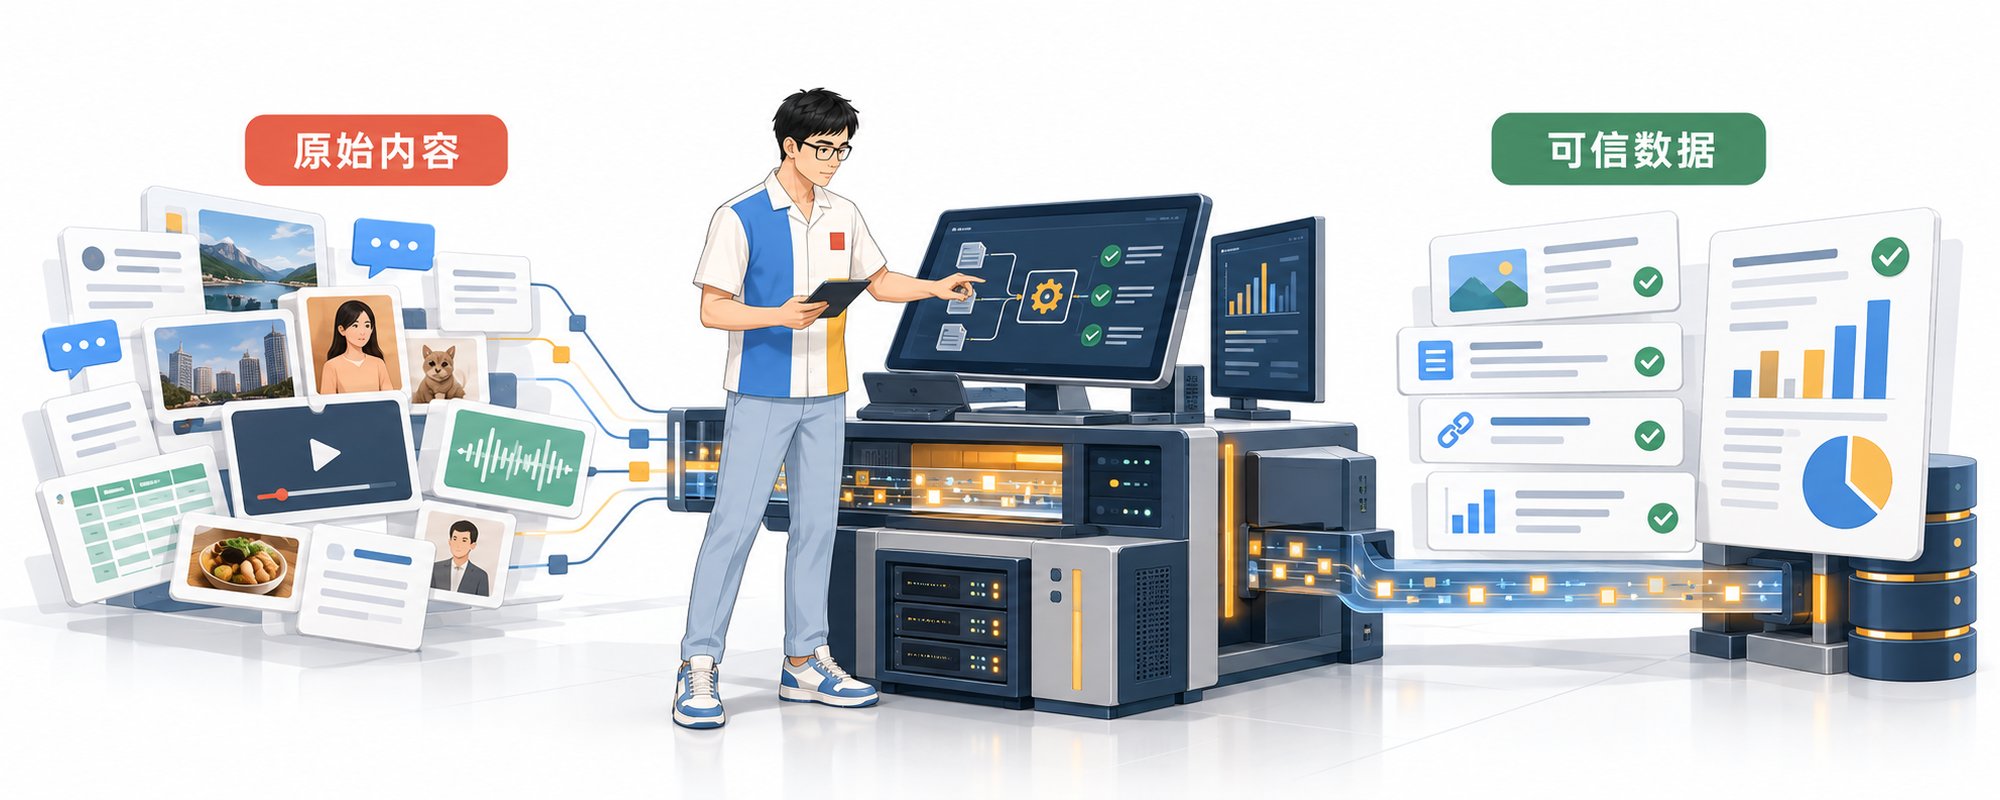
第四步多模态归一。文字保留原文再处理乱码、重复段落,模型提取观点时同时返回原句;图片用 OCR 提取价格、型号、日期和截图文字,再用视觉模型识别对象和场景,两种结果都要带图片位置;音频先统一格式和采样率再做 ASR,输出带时间码;视频拆音轨和关键帧,音轨 ASR、关键帧 OCR 和视觉识别,再按时间合并,没必要逐帧全量分析,先低频抽帧定位相关片段再加密。
工具选型上,小批量验证直接调 API,数据量稳定后再把高频任务搬到本地:FFmpeg 拆音轨、转码和抽帧,PaddleOCR 做本地 OCR,Whisper 做本地语音识别,云端可以接百度智能云 OCR、腾讯云 OCR、腾讯云 ASR 或火山引擎音视频字幕生成。选型别只看价格,拿自己的真实样本测方言、噪声、中英混合、竖屏字幕和截图小字,试用额度和并发限制上线前直接看控制台。
第五步处理冲突,先看证据。视频里 ASR 识别成 100、画面 OCR 识别成 11000,直接取置信度高的一方,错误数字会一路进统计。证据分级:A 级官方字段或人工确认,B 级原图、原音、原视频可直接确认,C 级多模型一致且上下文对得上,D 级单个模型结果,E 级关键词和规则候选。冲突就按时间码和图片位置找原始证据核对单位和上下文,确认不了的进待核队列,不参加精确数值统计;修正时保留原值、修正值、证据等级、原因、复核状态和模型版本,原值不被覆盖。
第六步把重复、低质量和异常分开处理。关键词和词典尽量找全,语义模型补简称、缩写和相近说法;完全复制、轻微改写、同图不同文、同视频再发布都放进同一个重复组,原始记录保留,统计时再定按帖子、素材还是账号去重;异常看发布时间、内容相似度、账号历史、发帖节奏和互动网络,输出正常可用、重复关联、低质量待修复、高风险人工复核四种状态,风险分只负责排序,活动统一素材和媒体矩阵也会高度相似,不能见高分就删。
第七步整理成可查询的结构化数据。一句“这款精华刚涂上挺润,过一会儿有点黏,敏感肌可能要先试一下”里有当前产品、候选产品、即时肤感、后续肤感、适用人群、风险提醒、价格区间和对比意向,只打一个负面标签后面根本没法用。通用结构分五类:谁在表达、评价对象是谁;提到了什么产品、部件、功能或服务;对象之间发生了什么;用户的观点、问题和意图;判断依据是哪句原文、哪个图片位置或哪段音频。大模型按固定 JSON 格式返回字段和证据,字段名、可选值和空值规则提前写清,低置信结果进人工复核。
第八步验收通过再按版本入库。检查原始内容和链接是否完整、评论能否回到原帖和上级评论、OCR/ASR/视觉结果是否带位置、冲突是否有处理状态、标签是否绑定正确对象、规则/模型/字段是否有版本号。再准备一批人工确认过的测试样本,含正常数据和易错难例,每次换规则、换模型都用同一批样本重跑;入库时原始数据、处理结果、质量状态和版本信息分开保存,任何一条数据在哪一步变了都能查清。
工具链接:
FFmpeg · PaddleOCR · Whisper · 百度智能云 OCR · 腾讯云 OCR · 腾讯云 ASR · 火山引擎音视频字幕生成