网站一改版,爬虫就全断——问题大多出在 CSS 选择器上:页面结构一变,写好的选择器全部失效,又得重写一遍。
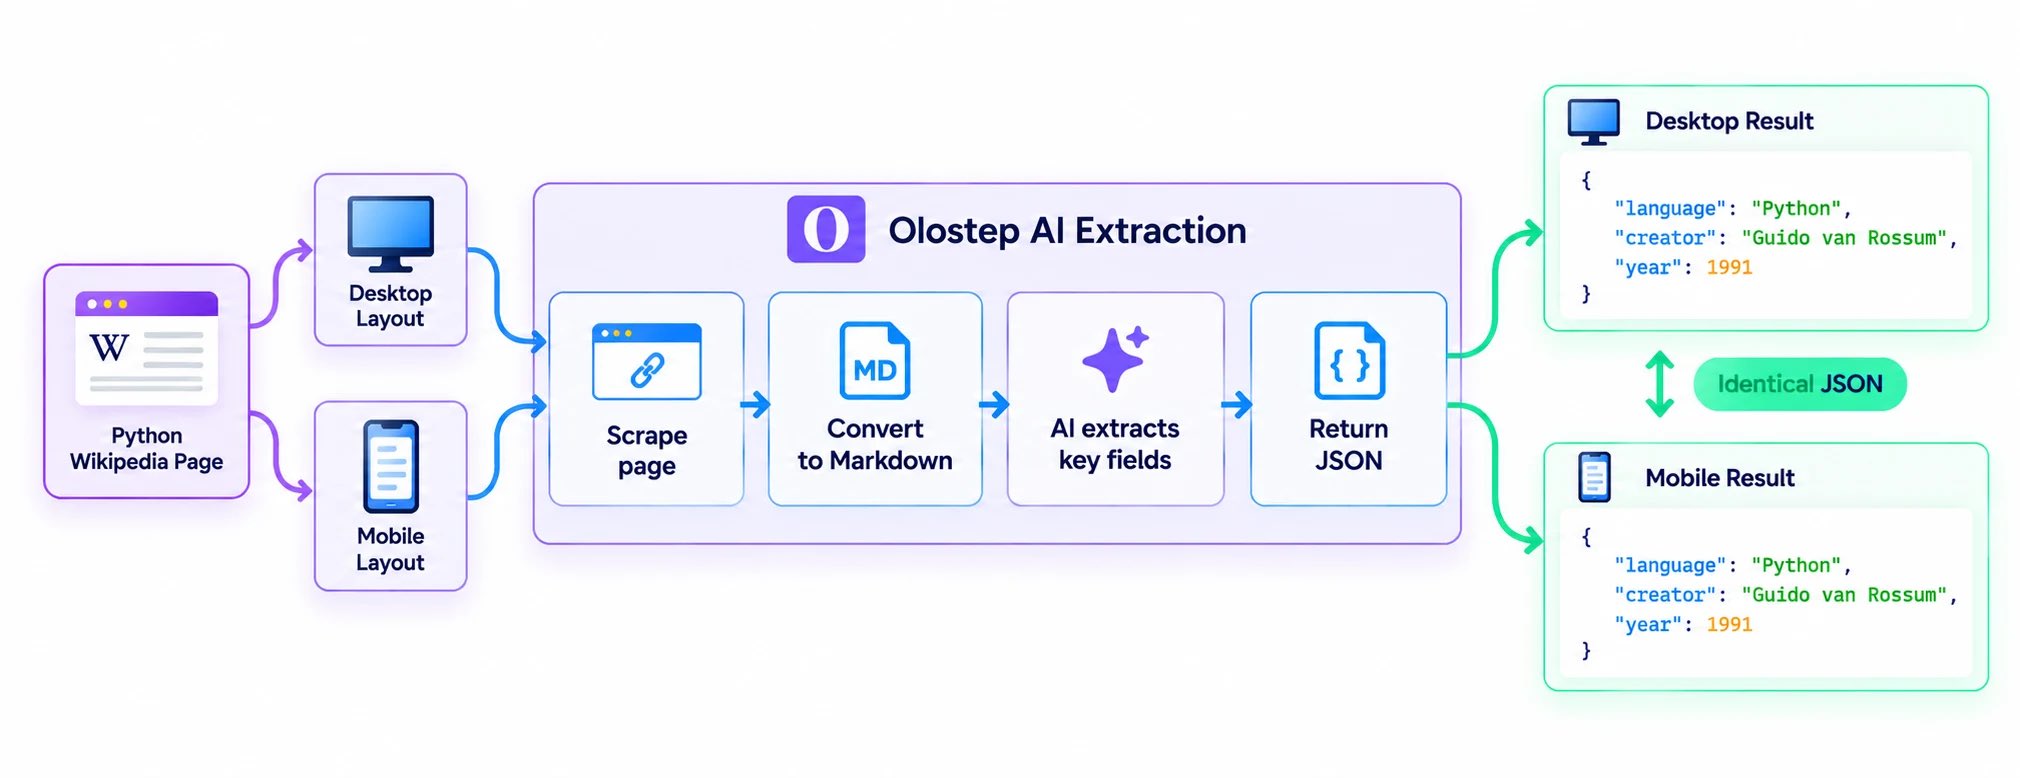
这次换个办法:不用写 CSS 选择器。用 JSON schema 定义好要什么字段,llm_extract 直接返回结构化数据,页面再改版也不用跟着改选择器。
核心就这几行:
scrape = await client.scrapes.create(
url_to_scrape=url,
formats=["html", "json"],
llm_extract={"schema": SCHEMA},
)
正文完