官方文档里 Terminal-Bench 那种 65.7% 对 30% 以上的碾压,到了真实用户场景里被狠狠稀释了。Agent Arena 的最新实测给出了另一组数字:Kimi K3.1 Pro 拿下开源第一,排第 11 位,提升 7.6%;DeepSeek V4.1 Flash-1017 紧随其后,排第 13 位,提升 4.4%。
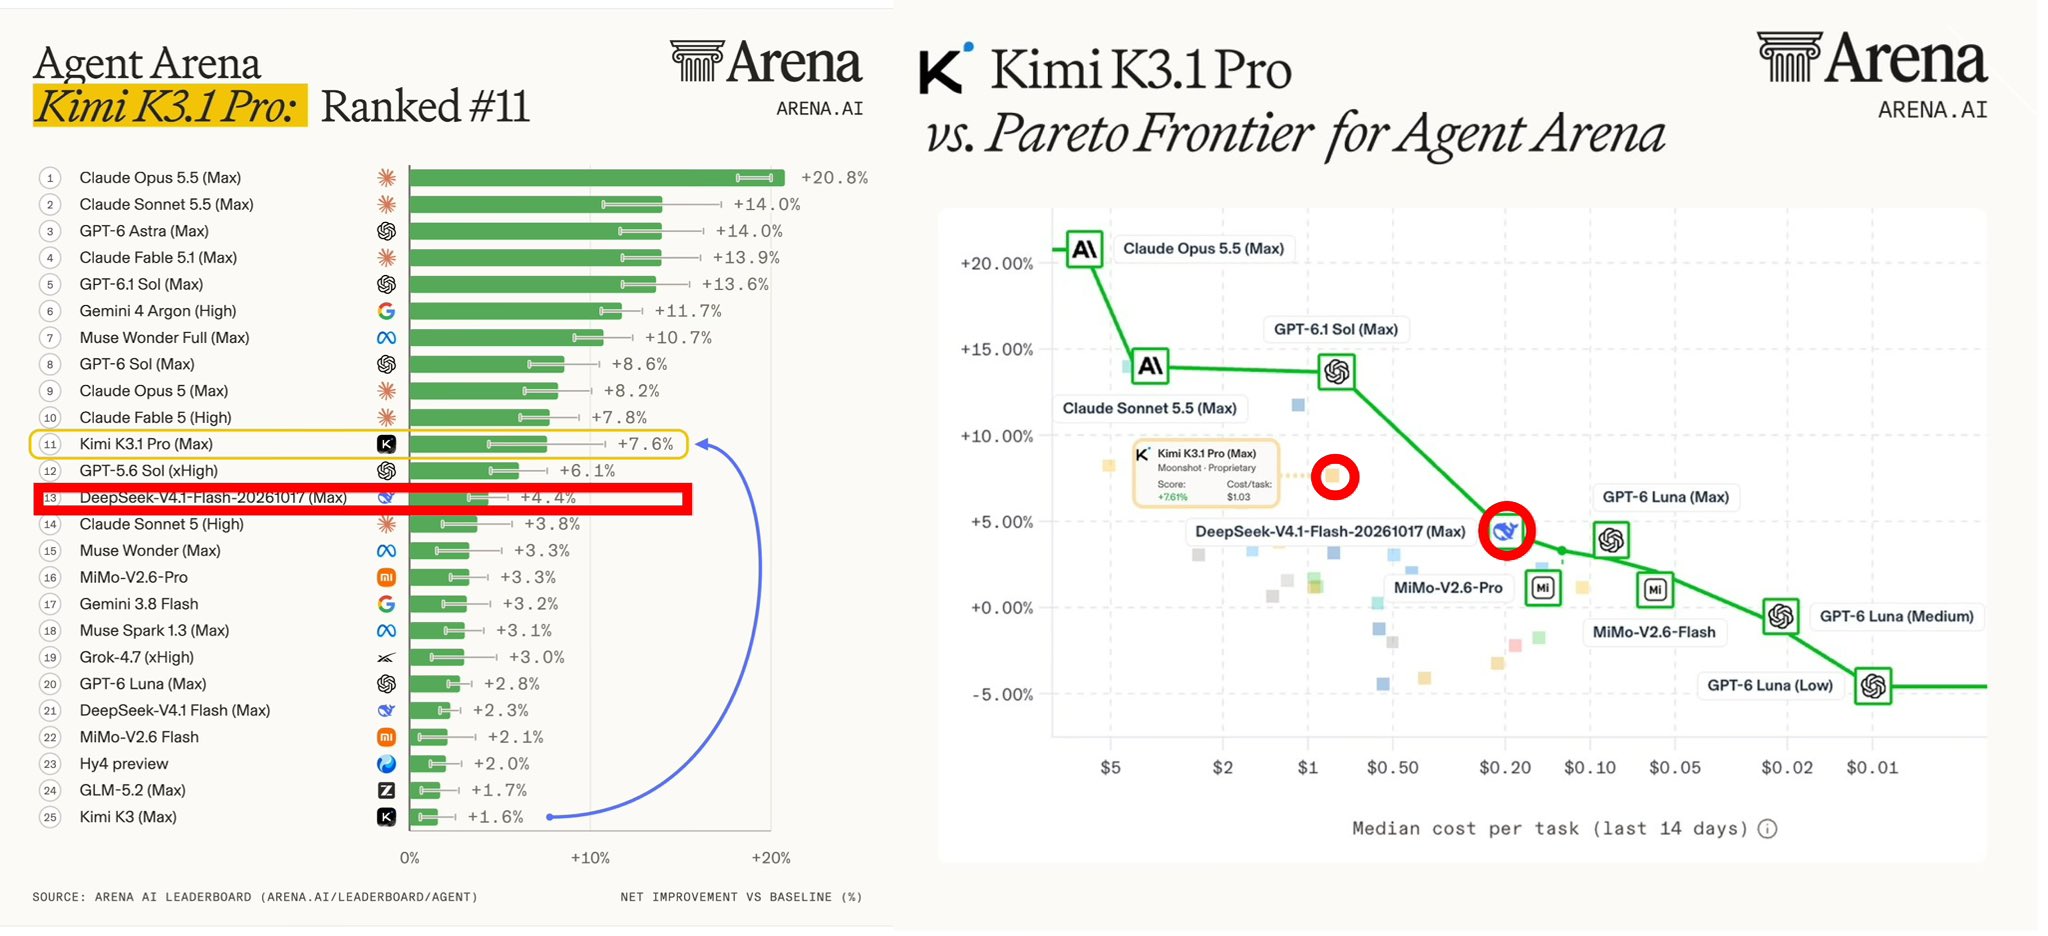
差距并不悬殊。实际观感上,Kimi 略强一点,但贵 5 倍以上;DeepSeek 性价比依旧爆炸,速度也更快。
这组对比也解释了为什么 Kimi 最近的口碑有些分裂:关键 benchmark 上仅与 Flash 持平,成本却高出一个数量级,订阅限额越缩越小,没订阅基本用不上。
选模型别只盯着官方宣传的分数。真实场景的排名、价格和速度加在一起,才是每天写代码、跑任务时真正要付的账。
正文完