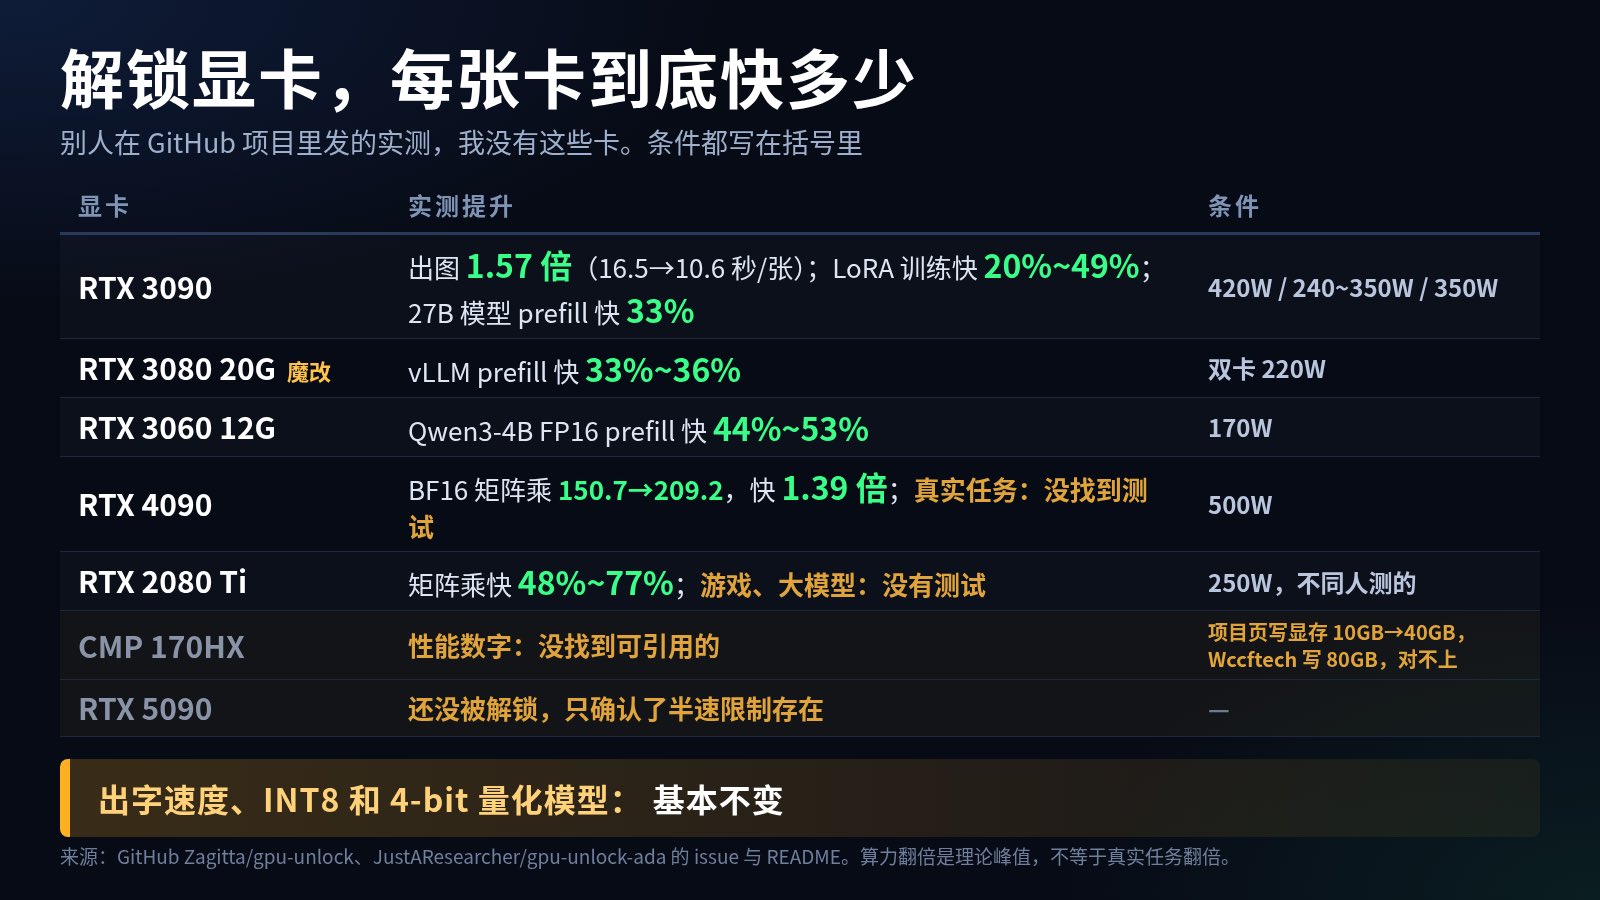
解锁显卡到底快多少?先说结论:算力翻倍是理论峰值,真跑任务要按卡型拆开看。3090 出图快 1.57 倍,LoRA 训练快 20% 到 49%,出字速度基本没变。
先说 4090 那组被传得很广的数字:165→331 是指令吞吐,也就是理论峰值。别人用 cuBLAS 在 450W 下复测,FP16 只涨 12% 到 34%,BF16 在个别矩阵尺寸上还不涨。车标称时速 330,不等于你上班路上能开 330。
这个解锁做了什么:开机早期利用固件漏洞,把 Tensor 的速率从半速改回全速,不刷 VBIOS,断电就恢复。
每张卡的数字,都是开发者在 GitHub 项目里发的实测:
RTX 3090:BF16 矩阵乘 72→115(350W);27B 模型 prefill,也就是读完你输入的长文那段,快 33%(350W),出字速度 112.9→114.3,几乎不变;出图 16.5→10.6 秒/张(420W);LoRA 训练快 20%(240W)到 49%(350W)。
3080 20G 魔改版:vLLM prefill 快 33% 到 36%(双卡 220W)。3060 12G:Qwen3-4B FP16 prefill 快 44% 到 53%(170W)。
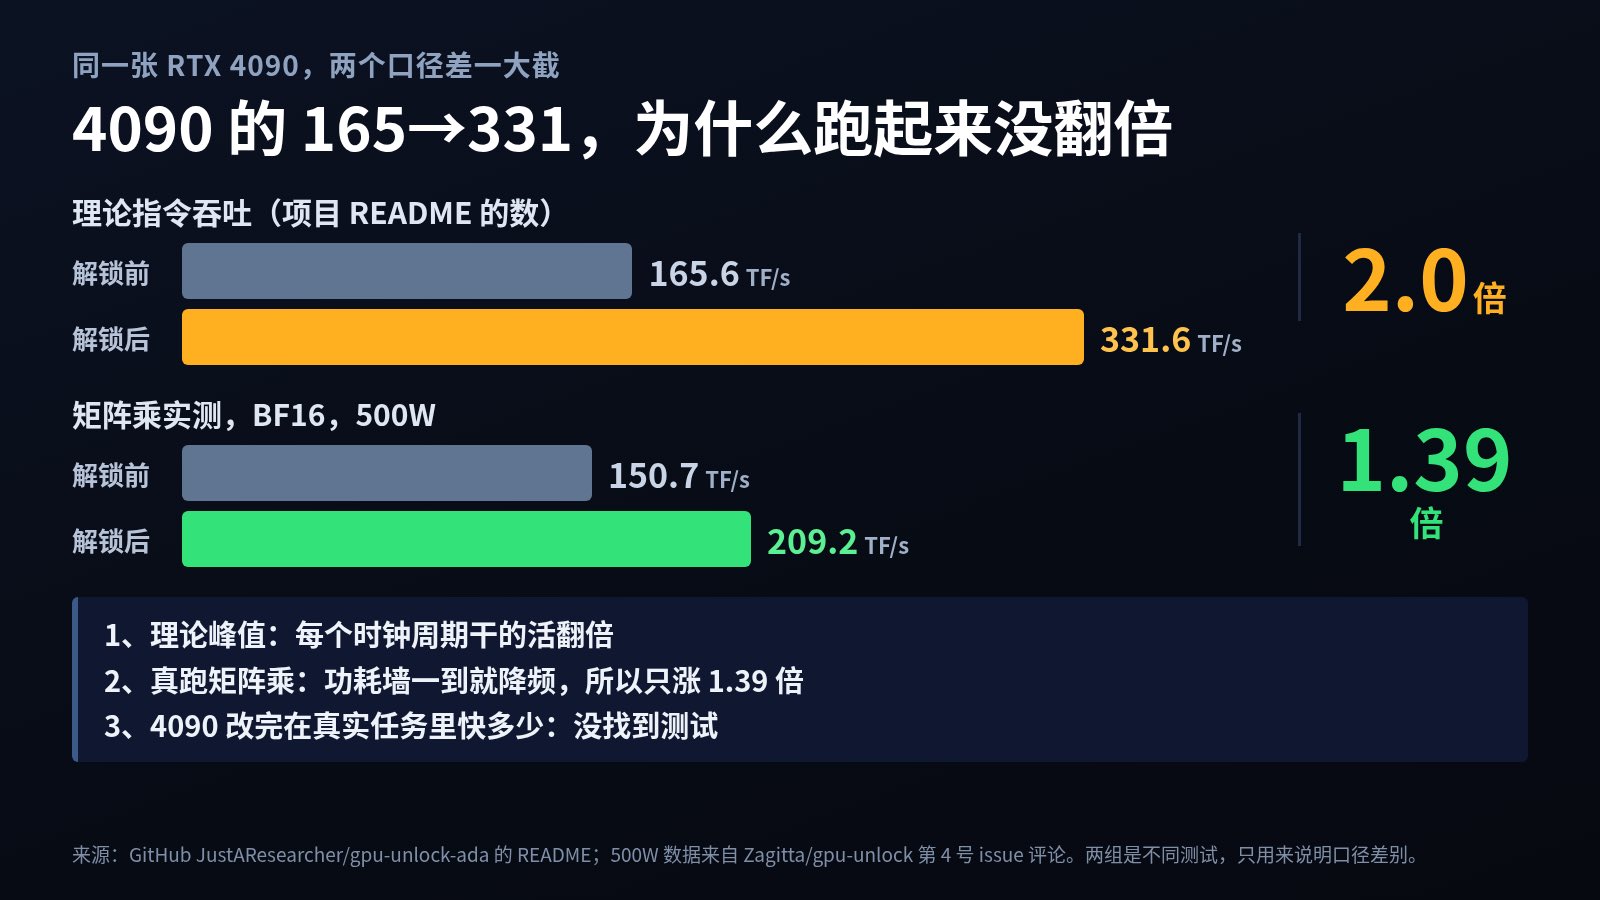
4090:500W 下 BF16 矩阵乘 150.7→209.2,快 1.39 倍;真实任务没找到原版 4090 的测试。2080 Ti:只解 FP16 累加,矩阵乘快 48% 到 77%(250W,不同人测的),游戏和大模型没有测试。CMP 170HX:项目页写显存 10GB→40GB,Wccftech 写 80GB,对不上,性能数字没找到可引用的。5090:还没被解锁,只确认了半速限制存在。
哪些活不变:出字速度、INT8 和 4-bit 量化模型。所以只用来聊天的人,基本没感觉。
风险也要说在前面:这是非官方改动。4090 的项目自己写了可能黑屏、无法启动、损坏硬件,首次要断电冷启动。想靠翻倍去收二手卡的,先看自己跑的是什么——做出图、LoRA 训练和长上下文 prefill 的人才有感。
实测数据来源:GitHub Zagitta/gpu-unlock、JustAResearcher/gpu-unlock-ada 的 issue 与 README。