DeepMind 刚发布的 Gemini 4 Carbon,最值得看的不是榜单位置,而是发力方向变了:网安与超长程自主任务。
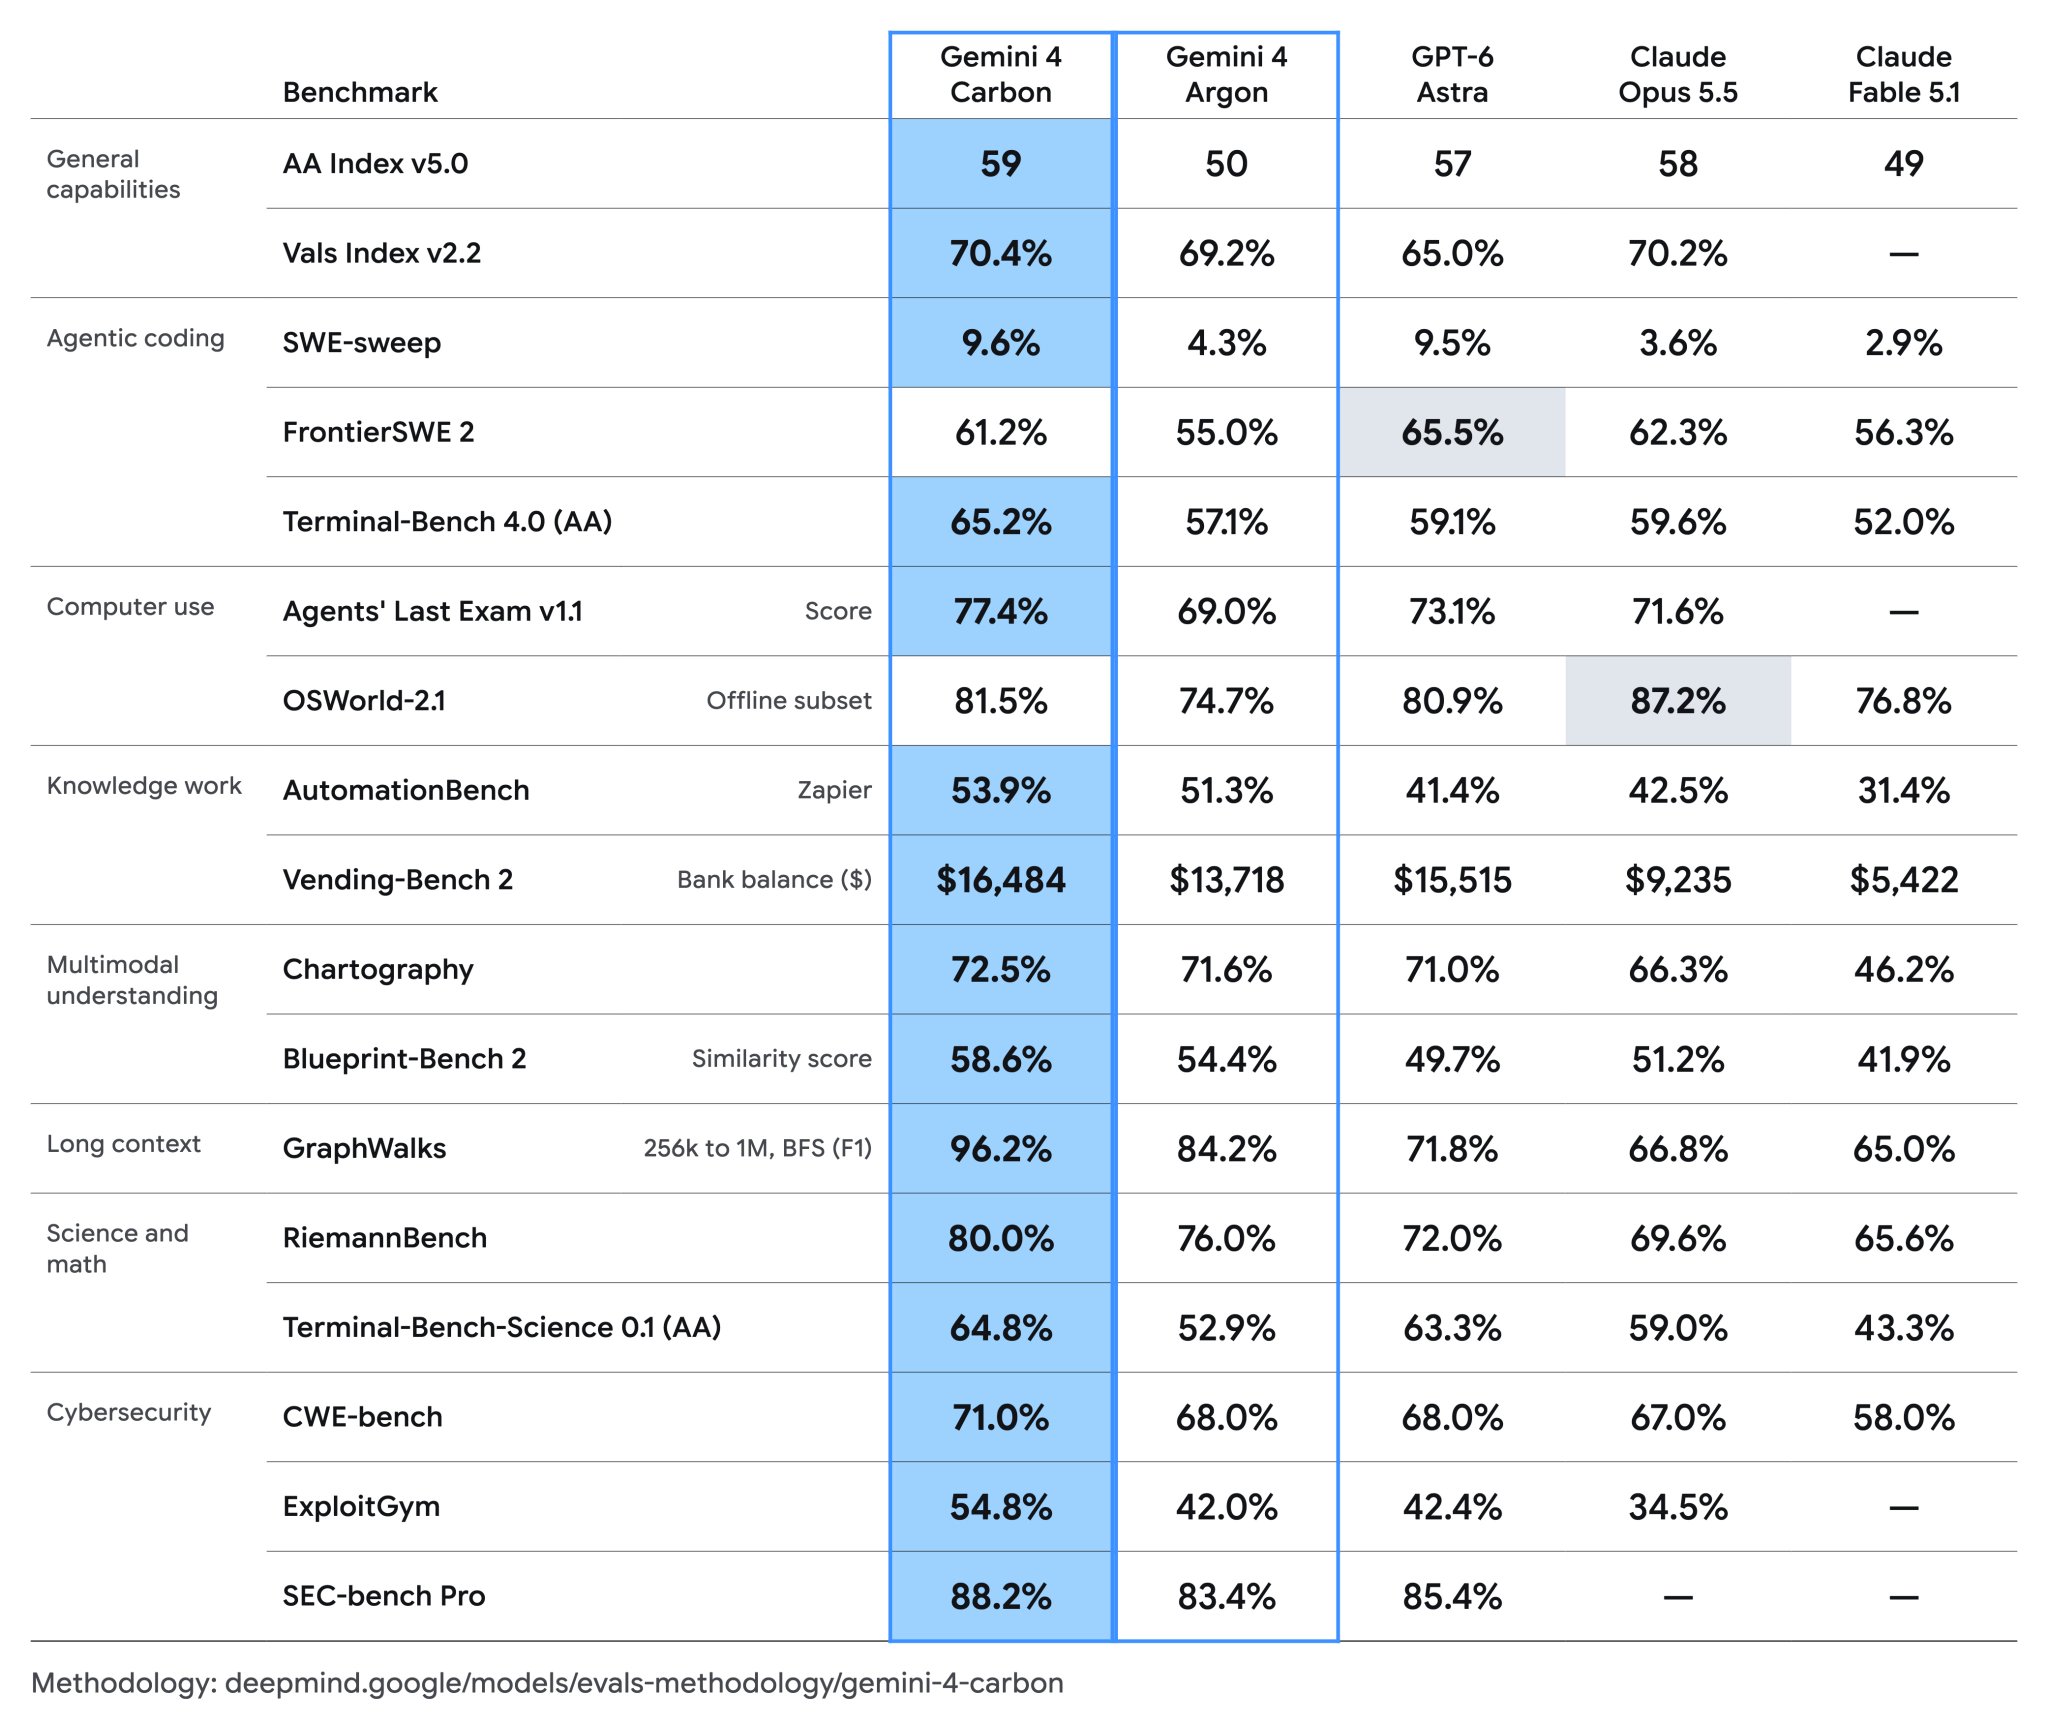
第一波战报里,总榜 Intelligence Index v5 它直接干到第一,59 分,但在 Coding Agent 榜单上依然咬在 Claude Opus 5.5 后面,屈居第二。只看排位,容易以为这又是一次常规迭代追赶。
真正折磨做自主 Agent 落地的人,不是单次 Prompt 的代码生成质量,而是任务链路一拉长,模型就会出现不可逆的认知衰减:上下文漂移、逻辑死锁、自我欺骗式地偷工减料,甚至干脆卡死在某个报错循环里。官方特意强调,Carbon 能够连续处理复杂任务数天而不卡死、不走捷径,这句话的分量很重——意味着它在上下文持久化、反思重试机制以及状态机维持上,可能拿出了底层的突破性方案。
如果代码 Agent 能在数十小时的尺度下保持逻辑一致性,模型才真正从写单个函数的 Copilot,演化成能独立承接整个模块重构的初中级工程师。
另外一个值得警惕的细节:官方这次首批仅向小范围的网安防守团队开放,做安全围栏迭代。潜台词很直白,模型在漏洞挖掘、协议分析和攻防推演上的端到端能力,已经触及可能引发现实破坏力的红线,不得不先关在笼子里做高强度的红蓝压测。
大模型的竞争维度已经从刷单轮基准分,全面切换到长程复杂工程交付。Anthropic 靠 Opus 5.5 在代码直觉上卡位,Google 则试图用 Carbon 在长时任务稳定性和网安垂直纵深上构筑壁垒。接下来就看防守团队的第一波实测反馈:能不能真正在全自动流水线里连跑几天不崩,才是它能否落地的试金石。
正文完