Firecrawl 新开源了一个 PDF 处理库 pdf-inspector,用 Rust 写,主攻快速分类加文本提取。文本型 PDF 不用 OCR 就能处理,本地一般 200 毫秒内搞定。
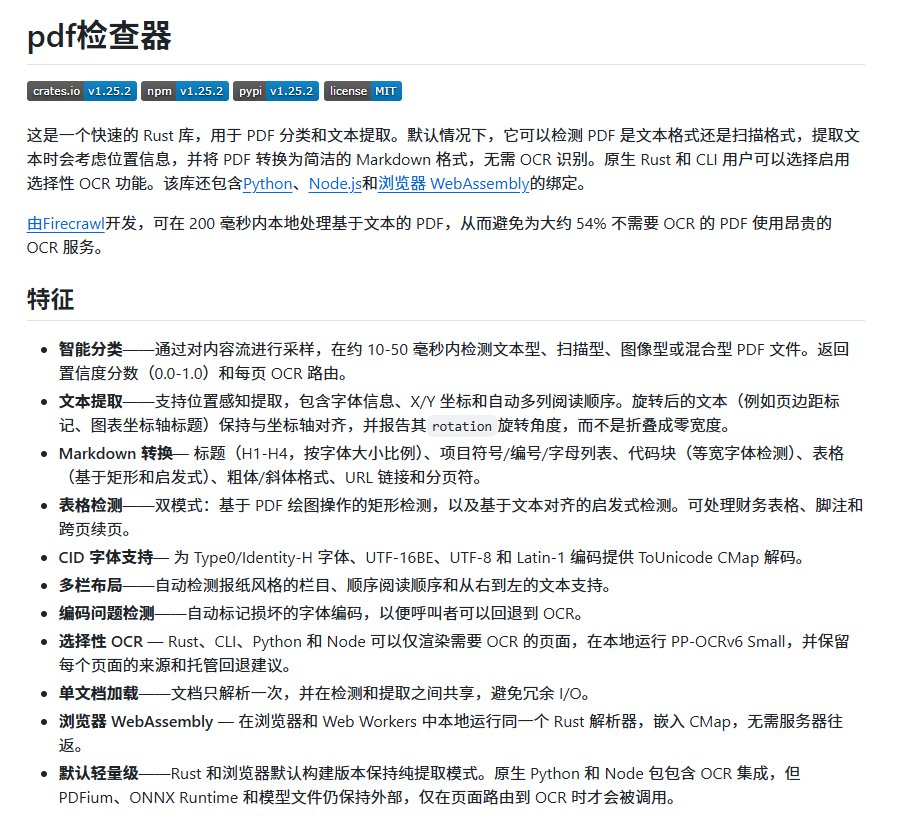
它会先自动判断 PDF 属于文本版还是扫描版,再提取带坐标的文字,并转成 Markdown。支持 Python、Node.js 和 WebAssembly,等于 Rust、Python、Node、浏览器四处都能跑。
官方测试说,大约 54% 的文档能直接跳过 OCR,外部服务调用也就少了。当然扫描版 PDF 还是得靠 OCR 兜底,它主要适合文本型文档。
仓库里的特征清单还列了不少硬货:智能分类在 10-50 毫秒内判断文本型、扫描型、图像型或混合型;位置感知提取保留字体、X/Y 坐标和自动多列阅读顺序,页边距、图表坐标轴标签能跟坐标对齐;Markdown 转换支持标题、列表、代码块、表格、粗斜体和链接;表格检测分基于绘图操作的矩形检测和基于文本对齐的启发式检测两种模式,能处理财务表格、脚注和跨页续表;选择性 OCR 只对确实需要 OCR 的页面在本地跑 PP-OCRv6 Small;浏览器 WebAssembly 版在本地跑同一个 Rust 解析器,不用服务器。
项目地址:
正文完