给第一个客户装 DGX Spark,装了一整套:Hermes、Qwen 3.8 Flash-Next、一个小 embedding 模型、数据库,再加聊天界面。客户选本地部署的理由很实在:成本能提前算清楚,用 API 的话每月账单都不一样;再加上德国的数据保护要求很严,数据放自己机器上才安心。
结果客户几乎没用。他没直说,但能看出来不满意,翻来覆去就一个愿望:想跟 agent 说话,而且一切都要自解释、不言自明。
这件事暴露了本地部署最容易踩的坑:给客户装了一堆模型,却没解决“怎么用”。作者也承认,STT(语音转文字)和 TTS(文字转语音)不值得上——会抢 LLM 用的资源,拖慢性能。更扎心的是一个提醒:90% 的人根本不知道 AI agent 是什么,更没用过。对普通人来说,一个能对话的 27B 模型,可能比 125B 的 MoE 更有用。
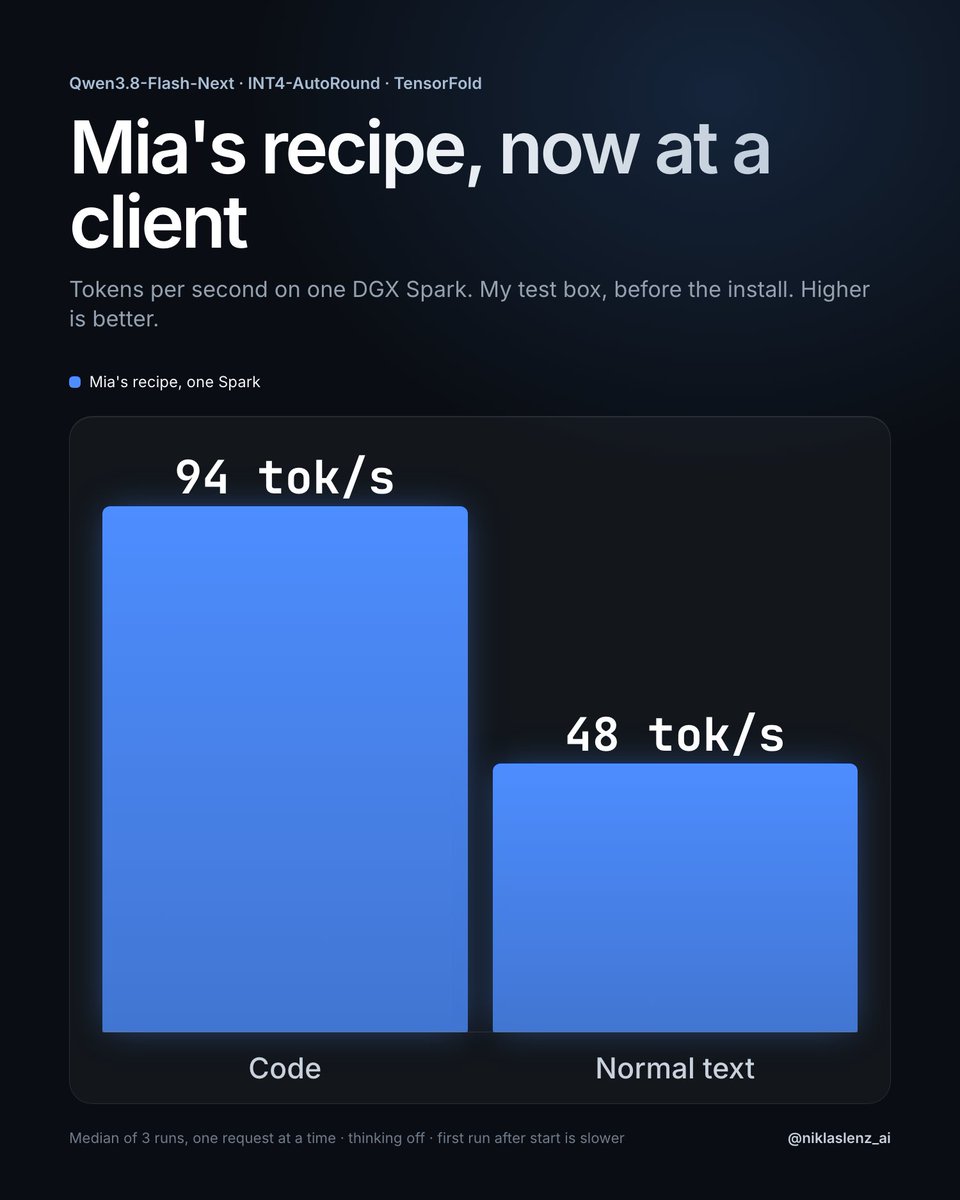
实测数据倒是不错。配图是 Qwen 3.8-Flash-Next(INT4-AutoRound,TensorFold)在单台 DGX Spark 上的速度:写代码 94 tok/s,普通文本 48 tok/s(3 次中位数,单请求,thinking 关闭)。机器能跑,问题不在性能,在体验。
下一步作者在看 LocalRouter 项目,可能是解决办法。这篇会持续更新,有新进展再说。
正文完