LLM 评估的老毛病是:让一个模型去给另一个模型打分,标准自己解读、推理自己发挥、结果自己生成——容易飘、贵、慢,JSON 还经常炸。DeepEval 新推出的 JevEval 换了个思路:不用生成式裁判,改用 Jev 做自定义评估裁判。
和传统 LLM-as-a-Judge 对比,JevEval 的决策结构由你定好:权重自己配,strict_mode 一开就是硬门槛。支持 Yes/No、分级 Score、Choice 三种题型,特别适合评 Agent 的执行轨迹:工具选对没、动作顺序对不对、任务到底完成没,都能直接判定。
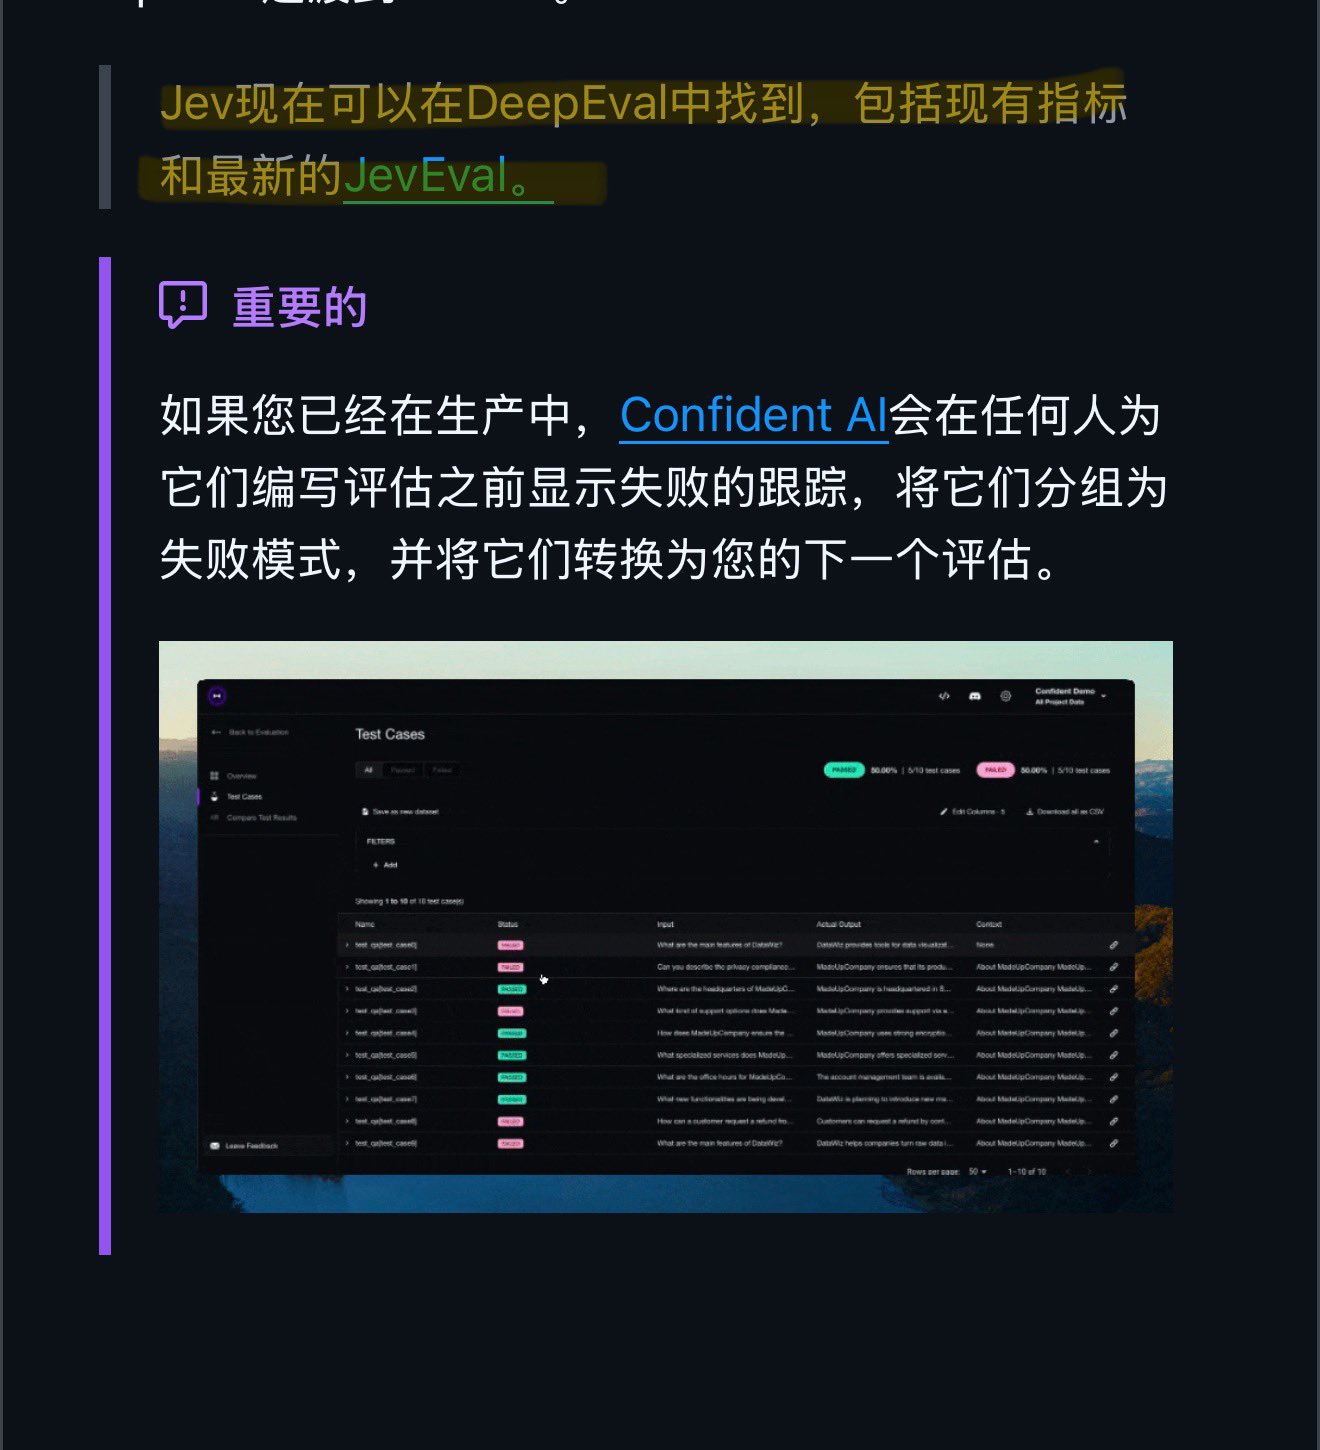
3 分钟上手流程:先装依赖 pip install -U deepeval typesafe-sdk;再配置 TYPESAFE 的 API Key;然后用 Noul(是/否)、Score(分级)、Choice(行为选择)定义判断问题,可加权、可开 strict_mode;最后丢进 JevEval 跑,支持单轮、多轮,甚至直接评 Agent 轨迹。
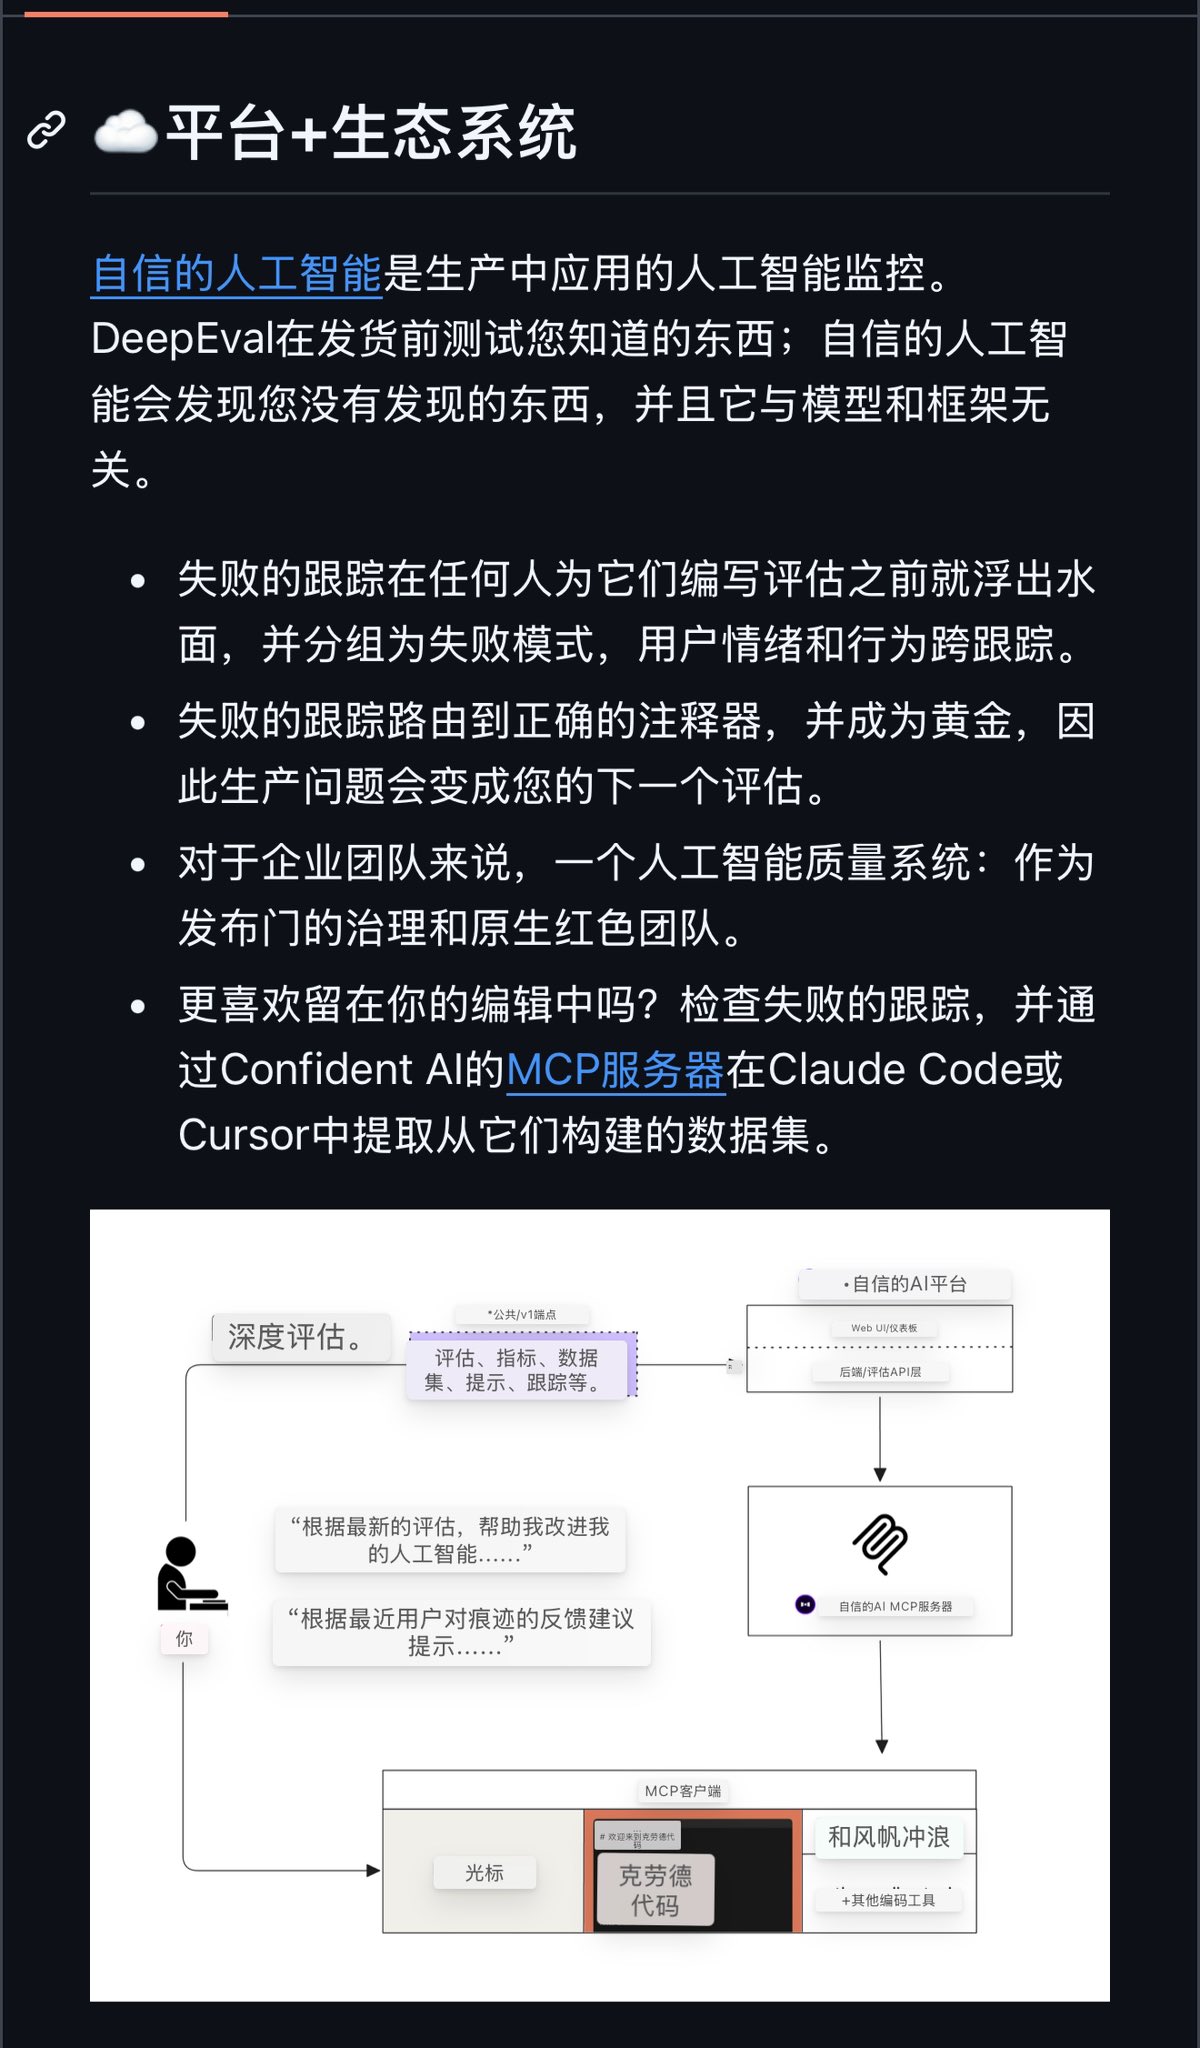
调用 evaluate() 后拿到的是 0–1 的稳定分数,外加可追溯的 score_breakdown,每一项得分从哪来都查得到。自定义评估这下真能当“规格说明书”用了,而不是每次换个裁判就换个结果。
正文完