只传一段配音,不用剪映、不用 AE、不用录音、不用会编程,Claude 就能把一期知识短视频从选题做到成片。这套方法已经连续做了 5 期抖音知识视频,每期 2~4 分钟、1080p,风格完全不同:星链新闻口播、AI 幻觉 Vibe 大赏、云的综艺漫画风、键盘 3D 动画短片、海獭纸片拼贴。
整条流水线只用三个 AI:Muse 负责选题和写稿,MiniMax 把稿子生成配音,Claude 把配音做成视频。Claude 这一段包括识别字幕、对时间轴、设计分镜、画画面、对口型、配乐音效、导出成片,全部用代码完成。
时间成本
以 3~4 分钟一期算:Muse 选题加写稿加改稿 20~40 分钟;MiniMax 生成配音加试听修正 5~15 分钟;Claude 识别加对齐加风格预览 10~30 分钟;Claude 写分镜和画面代码 30~90 分钟,看镜头数;渲染成片 2D 风格约 10~30 分钟,3D 风格慢得多,每帧 1~2.5 秒,2 分钟的片子要 1 小时以上。Claude 干活时不用一直盯着,可以先去准备下一期的选题。
准备:三样东西缺一不可
需要三个账号:Muse、MiniMax、能跑代码的 Claude。做 3 分钟的视频要跑很长时间、写大量代码,免费额度通常不够,建议用付费计划和能力较强的模型。最关键的一条铁律:交给 MiniMax 的稿子和交给 Claude 的稿子必须是同一份,一字不差。配音是照着稿子读的,Claude 对齐字幕时就几乎不会出错。
第一步:Muse 选题和写稿
选题直接发给 Muse,方括号里换成自己的账号信息:你是知识区的选题策划,账号定位和目标观众写清楚,让它给 10 个选题。要求就四条:有反常识或强好奇心的切入点、2~4 分钟能讲清楚、有画面感、每个选题给标题、开头第一句钩子、三个核心知识点、为什么可能会火。挑选题的小标准:能画出来的东西越多越好,有数字和对比,中间有反转。海獭那期就是典型:动物可爱、有“300 倍”这种数字、有“不是秀恩爱”的反转。
选定后在同一个对话里接着发:就用第 X 个选题,写一篇 3 分钟左右的口播配音稿。要求:一句一行,每行不超过 15 个字,每一行就是一条字幕;全文约 700~900 字;前 3 句之内抛出问题或反常识;每 20~30 秒一个小转折或新知识点;多用具体数字、对比和比喻,方便做成画面;结尾有一句情感升华或金句;不要括号、表情符号、英文缩写和小标题,只要能直接读出来的正文;正文写完后,另起一段列出稿子里所有事实和数字的来源。
拿到稿子后自己念一遍:拗口的地方改掉,疑似不对的数字追问来源。后面 Claude 还会再核实一遍,比如海獭那期的“20~30 公斤”,就是 Claude 核实时指出只对母海獭成立。
第二步:MiniMax 生成配音
打开 MiniMax Audio 网页版或开放平台,选音色:用平台自带的音色,或者用“音色复刻”克隆自己的声音,只克隆自己或已经授权的声音,配音的性别要和数字人形象一致。把整篇稿子粘贴进去,一句一行的换行和标点会变成自然的停顿。先试听一小段调语速,短视频建议比正常说话稍快一点。生成后从头听一遍,重点听多音字、数字和英文的读法,读错了就改稿子再生成。下载 MP3。
两个小技巧:整篇一次生成,不要分段拼接,否则前后音色和音量可能不一致;为了读对而改过的稿子,就是交给 Claude 的那一份。
MiniMax 语音模型介绍:
https://www.minimax.cn/news/minimax-speech-26
第三步:交给 Claude,十个环节走完
手里应该有三样东西:MiniMax 导出的 MP3、最终版稿子(一句一行)、下文的系统提示词,可选再加一张数字人形象图。开一个新对话,把东西一次发齐,最后加一句:“这是这一期的配音,题目是《XXX》,发在抖音,横屏。”一期视频用一个对话,做完这期再开新对话做下一期,不容易串。
第 1 步,Claude 确认音频时长,检查环境里有没有 ffmpeg 和 Python 库,缺什么装什么,你检查它报的时长和配音对不对得上。第 2 步,语音识别加字幕对齐:用离线语音识别模型(SenseVoice 或 Whisper)转出每个字的时间点,再拿文稿去对齐,得到每句字幕几秒出现、每个关键词几秒说出口。它会发你一份字幕对照,重点看专有名词、数字、英文。如果它说下载不了识别模型,就用剪映识别字幕导出 SRT 发给它。
第 3 步是选风格,最重要的一步:让它给 4 个不同风格的预览,比如插画、漫画、拼贴、复古印刷,每张都是用这期的真实内容画的 1920×1080 预览图,配一句说明。选错风格后面很难改,宁可让它多画一轮,也可以混搭。第 4 步分镜表:把配音切成 20~40 个镜头,每个镜头说清楚从哪句话开始、画面是什么、屏幕上跳什么大字、动效卡在哪个词上。赶时间就回一句“分镜你定,直接做”。系统提示词里还要求它把屏幕上的大数字查一遍。
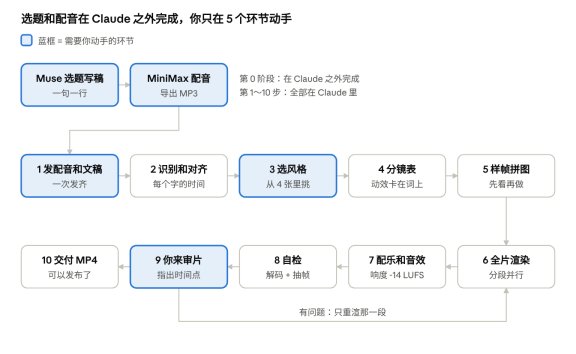
第 5 步先看样帧再出全片:写好全部画面代码后,先从每个镜头抽一帧拼成一张大图自己检查,文字重叠、元素出画、文字被挡这类问题它会自己修掉,这一步改方向成本最低。第 6 步渲染全片:把视频分成几段并行渲染,逐帧画好交给 ffmpeg 编码,你等着就行,可以问“进度怎么样”。第 7 步配乐、音效、混音:用代码合成一段原创配乐,不存在版权问题,在每个画面元素出现的时刻加音效,人声出现时音乐自动压低,整体响度调到 -14 LUFS。想自己换抖音热门音乐,就告诉 Claude“只要人声和音效,不要配乐”。
第 8 步自检:从头到尾解码一遍确认没有坏帧,核对时长和音频对得上,量响度,在分段接缝和转场处抽帧看一遍。第 9 步你审片,提意见要具体到时间点和现象,比如“1:23 那个大字和字幕重叠了”,它只重渲有问题的那一段,再重新混音导出。第 10 步拿成片:它会把最终 MP4 发给你,说一句“工程源码不用给我,只要最终视频”,就不会发一堆文件。
系统提示词:复制即用
把下面这段放进 Claude 项目的“项目说明”里,以后每期只传配音;或者每次新对话第一条消息就贴上它。方括号里的内容按自己的情况改:角色是短视频制作团队,导演加分镜加动效设计加剪辑加混音,用代码完成从配音到成片的全部工作。成片规格:平台抖音,画幅横屏 1920×1080 或竖屏 1080×1920,24 或 30 fps,H.264 加 AAC 48kHz,响度 -14 LUFS,真峰值不超过 -1.5 dBTP,文件尽量控制在 200MB 以内,只交付最终 MP4。
工作流程严格按顺序:环境检查,确认 ffmpeg、Python 库和中文字体可用;转写用离线语音识别得到字级时间戳,模型下载失败就停下来让用户提供剪映导出的 SRT,绝对不要凭空估计时间戳;对齐用文稿纠正识别结果,逐字对齐,生成每句字幕的起止时间和每个字的时间,写两个工具函数 L(i) 等于第 i 句开始时间,W(i, “词”) 等于第 i 句里某个词说出口的时间,把字幕对照发用户核对;风格预览画 4 张风格完全不同的预览图,等用户选定前不要开始做全片;分镜要求前 3 秒必须有钩子,平均 3~8 秒换一个镜头,每个动效都卡在对应的词说出口的瞬间,数字、关键词、结论用大字上屏,每个镜头只有一个视觉焦点,屏幕上出现的事实和数字先联网核实,发现配音里有错误告诉用户,但不要擅自改配音。
画面全部用代码画,2D 用 Pillow、numpy、opencv,3D 用 Three.js 加无头浏览器,不要使用有版权的角色、logo、网图。数字人口型按字级时间戳加每个字的拼音决定嘴型,再用音量包络控制开合大小,每 3~5 秒眨一次眼,头部只用缓慢的正弦小幅摇摆,绝对不要跟着音量抖动。字幕底部居中,一次一行,1080p 下字号不小于 48px,带底板或描边,和画面风格统一,不能和画面大字重叠。渲染先渲染每个镜头的样帧拼图自己看一遍,逐帧把像素通过管道送进 ffmpeg 编码,按 CPU 核数分段并行,每段先写成 .part 文件,完成后再改名。音频用代码合成原创配乐,在元素入场、转场、强调处加音效,人声出现时自动压低音乐,音乐整体比人声低约 12dB,最后 loudnorm 到 -14 LUFS。自检交付前必做:ffmpeg 完整解码一遍无报错,时长、分辨率、帧率、音频核对,测响度,在分段接缝、转场、片尾抽帧拼图并亲自看一遍。沟通方式:只在真正需要用户决定时提问,每完成一个阶段用一句话告诉用户,提修改意见时只重做有问题的部分,不要推倒重来,命令或下载失败时换一种方法,不要反复重试同一个命令。
风格菜单:题材决定风格
新闻口播加数字人适合新闻解读、科技动态、行业分析,渲染快;Vibe 动效风适合 AI、互联网、科普反常识,渲染中等;综艺漫画风适合生活科普、自然现象,渲染中等;火柴人适合心理学、职场、生活技巧,渲染快;3D 动画适合有故事情节的话题,渲染慢;纸片拼贴适合动物、温情科普、历史,渲染快;水彩绘本适合亲子、自然、故事,渲染快;复古印刷适合文艺、设计、读书,渲染快。发给 Claude 时直接说风格名即可。提醒一句:代码画不出写实照片的质感,想要写实画面,就把 AI 生图工具生成的素材图发给 Claude,让它在视频里组合和加动效。
踩过的坑
数字人一直抖,是头部摇摆跟着音量走,改成缓慢的正弦运动,切镜时的推拉幅度减半。字串到了别的镜头上,是带缓存的图片被直接在上面画了字,在缓存图上画东西前先 copy。不同镜头的元素互相串位,是两个镜头用了同一个元素名,缓存名前面加上镜头编号。成片只有一半长,是某一段渲染中途报错退出,合并时没发现,每段先写 .part,完成才改名,合并前检查每段都在。并行渲染互相打架,是用 shell 的 & 同时启动,进程被提前杀掉,每段单独用后台任务启动。某一秒突然爆音,是同一个时刻叠了 17 个一样的音效,音效按时间去重,导出前查峰值。配乐盖过人声,是音乐只比人声低 6dB,压到低 12dB 左右,并且人声出现时自动压低音乐。文件太大近 300MB,是画面加了纸张颗粒,码率上去了,限制最大码率 6Mbps,4 分钟约 190MB。识别模型下载不了,是有些环境不能访问模型网站,用剪映识别字幕,导出 SRT 发给它。命令被安全检查拦下,是运行从网上下载的程序会被拦,或者官方服务在出故障,对于可自行实现的功能,让它自己写代码,服务故障就去 status.claude.com 查看,恢复后重试。
常见问题
MiniMax 把字读错了,修改稿子后重新生成配音,多音字可以换成同义词,数字读错可以改写成汉字,修改后的最终稿就是交给 Claude 的版本。能不用 MiniMax、自己录吗?可以,在安静环境下用手机录音即可,念错或临时修改的内容必须同步更新到稿子里,确保文稿和配音一字不差。Muse 写的事实可靠吗?不一定,让 Muse 列出信息来源,Claude 制作分镜时再联网核实屏幕上的数字和关键事实。可以做竖屏吗?可以,开始制作时直接说明“竖屏 1080×1920”,让 Claude 按竖屏比例重新设计排版,不要直接裁剪横屏视频。不想要数字人可以吗?可以,纯动画、纯拼贴、纯 3D 都行。能用自己的照片当数字人吗?技术上可以,但只能使用自己的照片或已经获得明确授权的人物形象。画面里能放动画角色或品牌 Logo 吗?不建议未经授权使用受版权或商标保护的素材,让 Claude 设计原创角色或原创视觉元素。中途对话太长断了怎么办?在同一个对话里输入“继续”,如果工程文件和上下文仍然存在,Claude 可以继续制作,如果上下文丢失,则需要重新提供工程文件和制作进度。