听起来有点离谱,可微软真把它做出来了——100B 参数的模型,CPU 也能跑。
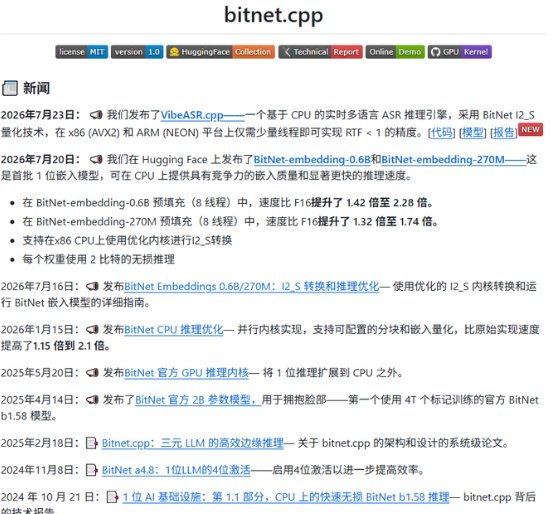
关键不在换了更强的硬件,而是微软的 BitNet 把计算方式改掉了。传统大模型大量依赖浮点乘法,BitNet 却把权重限制成 -1、0、1,原本复杂的乘法,很多时候就变成了加、减或者直接跳过。
结果就是:CPU 推理最高快约 6 倍,能耗最高降低 82%,模型越大,优势越明显。更狠的是,它不是训练完普通模型再压缩,而是从训练阶段就采用这种 1.58-bit 权重——只有 3 种取值,信息密度约为 log₂3 ≈ 1.58 bit。
真正有意思的地方,不在“100B 模型能不能跑在 CPU 上”,而在于:AI 算力瓶颈,或许不只靠堆硬件解决。
正文完