整本书一次读完,才是 OCR 该有的样子。百度今天刚开源 Unlimited-OCR-2,一个 3B 参数的模型,MIT 协议开源,几百页的财报卷宗一次解析,不用再逐页拼。
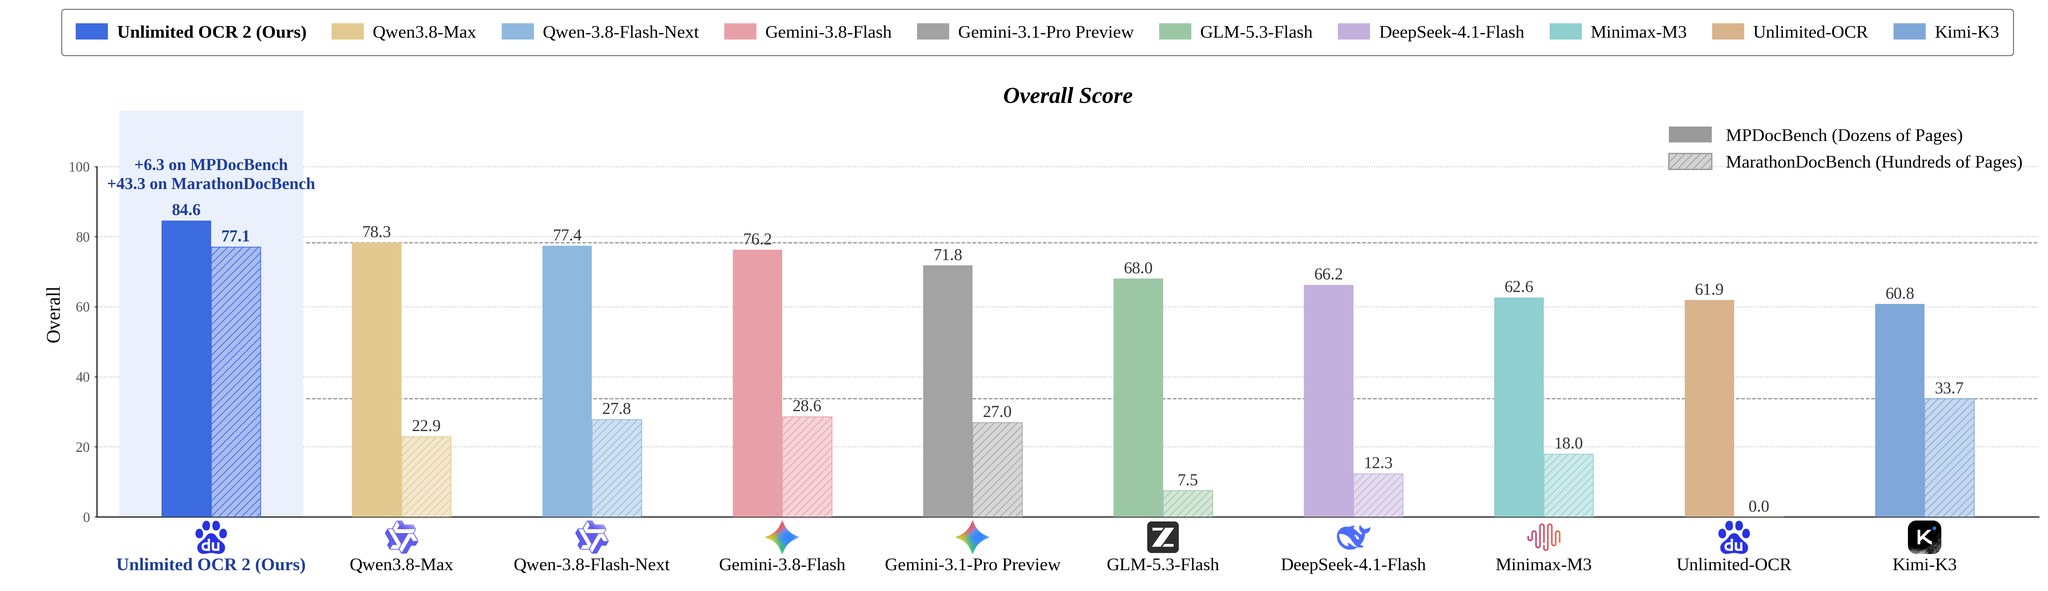
长文档解析最怕的就是断在中间、上下文接不上。Unlimited-OCR-2 的思路是整本一次读完:几十页的文档,百度自测 84.6 分;几百页的大部头,也能拿到 77.1 分。同场对比里,第二名 Kimi-K3 只有 33.7 分,差距直接断层。
Mac 用户当天就能用上,官方同步放出了 MLX 版,本地就能跑。财报、卷宗、论文这种几百页的长文档,丢进去一次出结果,不用拆文件、不用反复拼页。
项目地址:
正文完