AA Intelligence Index V5 出来后,前沿排名几乎完全洗牌,开源和闭源的分数差距也进一步拉大。但这份榜单还是有不少问题,按实际体验修正之后,才比较准。
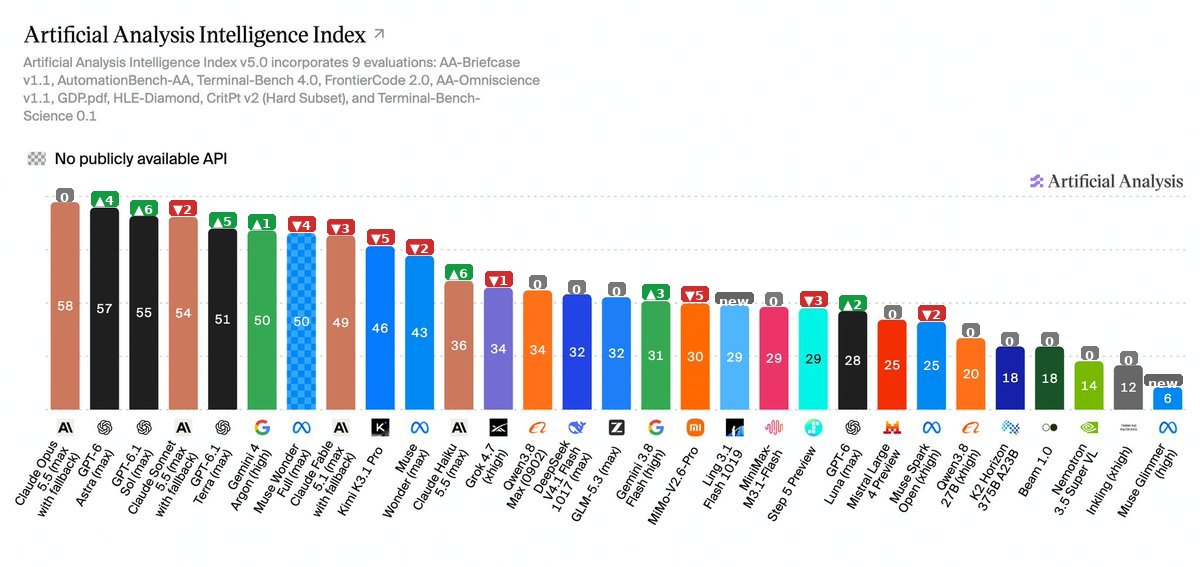
- GPT 的模型,如果是通过 Codex 使用,至少降 3 分来看,实际体验会降更多。
- Terra 比 Fable 5.1 强完全不成立,这个模型实际表现不如 DeepSeek V4.1 Flash。
- Grok 4.7 应该换成 4.6,4.7 大概是 20 分,实际表现应该和 Qwen 3.8 27B 差不多。
- Haiku 5.5 和 DeepSeek V4.1 Flash 差不多,DeepSeek 是被低估了。
- Muse 完全没用过,不评价。
加上这些改动,这份榜单就能反映实际体验了。选模型的时候,别只看原始分数,先按自己常用的入口和使用场景打个折。
正文完