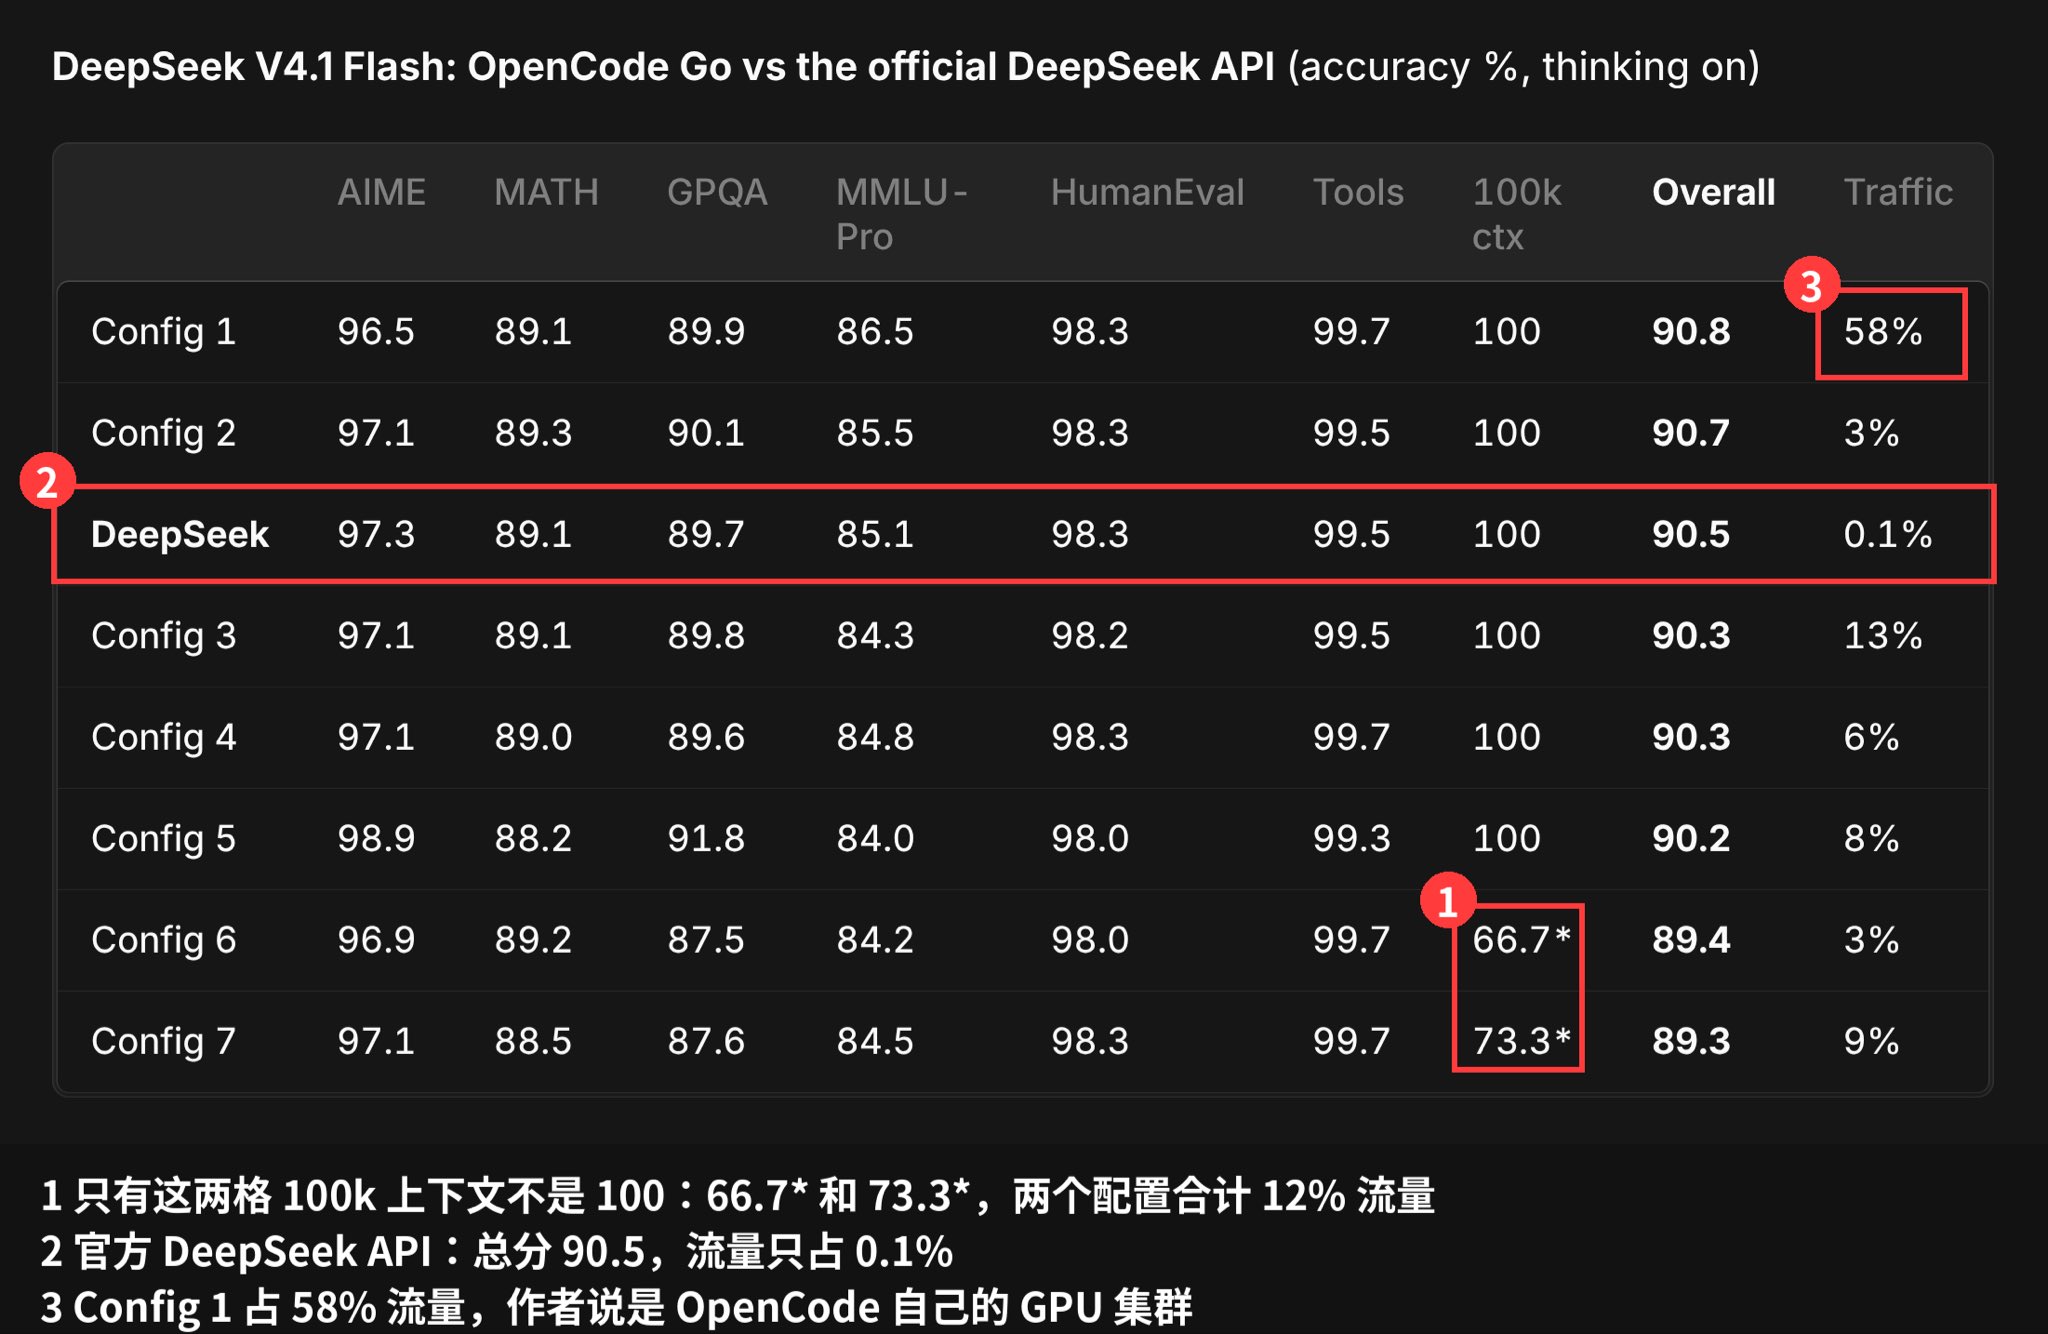
你是不是觉得 OpenCode 里的 DeepSeek 变笨了,变慢了?今天凌晨 OpenCode 作者出来发帖,把 7 个配置拉去跑了基准:DeepSeek V4.1 Flash 各配置总分在 89.3 到 90.8,对比官方 API 的 90.5,基本在同一区间。作者给出的跑分没问题,但他说的“没变笨”,绝不等于大家用起来“没问题”。被冤枉的是模型,白白折腾的是干活的用户。
被你当成变笨的,其实是报错
作者在评论区承认,带星号的两个配置已经被他们下掉了。这两个配置在 100k 上下文那一列只有 66.7 和 73.3,合计占了 12% 流量。原因是上游加了内容过滤,触发太多,作者原话承认“用户只会看到报错,不是模型变笨”。10 天前就有用户在 GitHub 提了第 57814 号 issue,用日志证明拦截只发生在 deepseek-v4.1-flash,GLM 一次都没有,结果当时被机器人直接关帖。写代码频繁弹错中断,用户自然以为模型变傻了。
真正变差的是速度
作者承认 TPS 确实比 DeepSeek 官方慢,原因是硬件不够,找 GPU 还要时间。OpenCode 自建的集群占了 58% 流量,扛不住峰值时会把请求转到官方 API,所以用它还得在隐私设置里选 Global。速度慢到什么程度?有用户在第 59902 号 issue 里自测:Go 的首字等待中位数是 3.1 秒,直连是 1.5 秒;超过 10 秒的卡顿,直连是 0,Go 占了 5.7%。写代码最怕卡壳,响应断断续续,体验自然稀烂。
只给跑分,不给细节
评论区有人追问各配置到底用了哪家 provider、到底有没有搞量化,作者只回一句“我们公开的比任何公司多一百倍”,对量化一句不答。还有人指出单轮基准说明不了什么,真正该测的是长上下文和工具调用,作者同样没回。把跑分单亮出来,却把底层关键信息捂着,这不是解决问题的态度。
作者承认大家遇到的问题“很可能是真的”。如果你现在还在用,三个建议:别急着骂模型,先看中断是不是报错弹窗,再看是不是正好踩中用量高峰;反馈带上硬信息,真要反馈去私信作者,带上控制台网址里的 workspace id、发生时间和现象;干活别只赌一个渠道,追求稳定和速度,手里多留一个直连或者备用工具,随时准备切换。