M6 芯片的本地 AI 实测数据来了,纠结买多大内存的人,先看这组数字再下单。同一颗芯片的 Mac mini M6 上,Qwen3.5-9B 读取 prompt 能到 742 token/s,是 M4 的 3.5 倍,首字延迟只有 0.7 秒,日常对话体感已经很跟手。
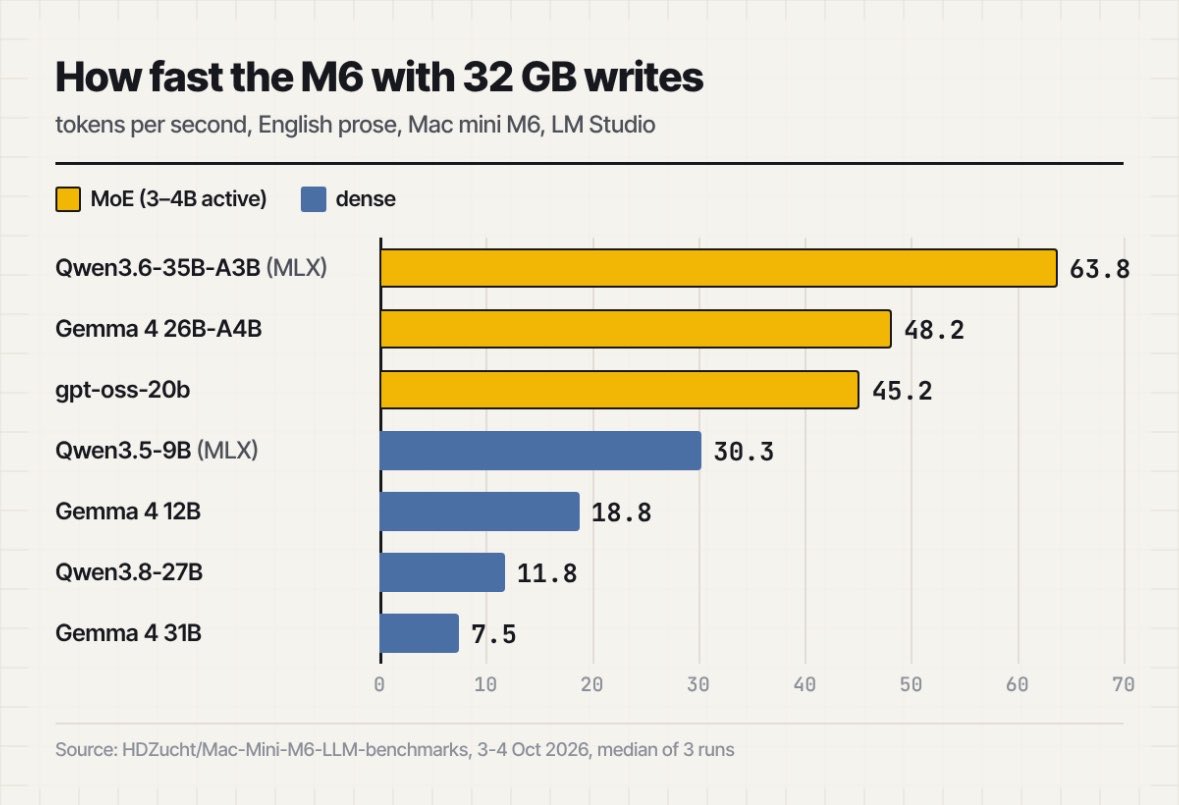
真正拉开差距的是模型结构。混合专家模型最划算:Qwen3.6-35B-A3B 能跑到 63-69 token/s,而参数量更小的稠密 27B 模型反而只有 11-12 token/s。只看参数大小选模型,很容易选错。
内存才是硬门槛。16GB 版本装上浏览器和日常应用后,留给模型的空间只够约 12B 级;想顺畅玩 30B 级,24GB 起步才稳。11 月 6 日发售,内存焊死在芯片里,之后没法加,所以买之前先定好你要跑的模型,再定内存,别先买了再后悔。
正文完