两家中国大模型公司的招聘标准,反差强烈到近乎对立:一个赌未来上限,一个要即时战力,背后是赤裸裸的算力鸿沟。
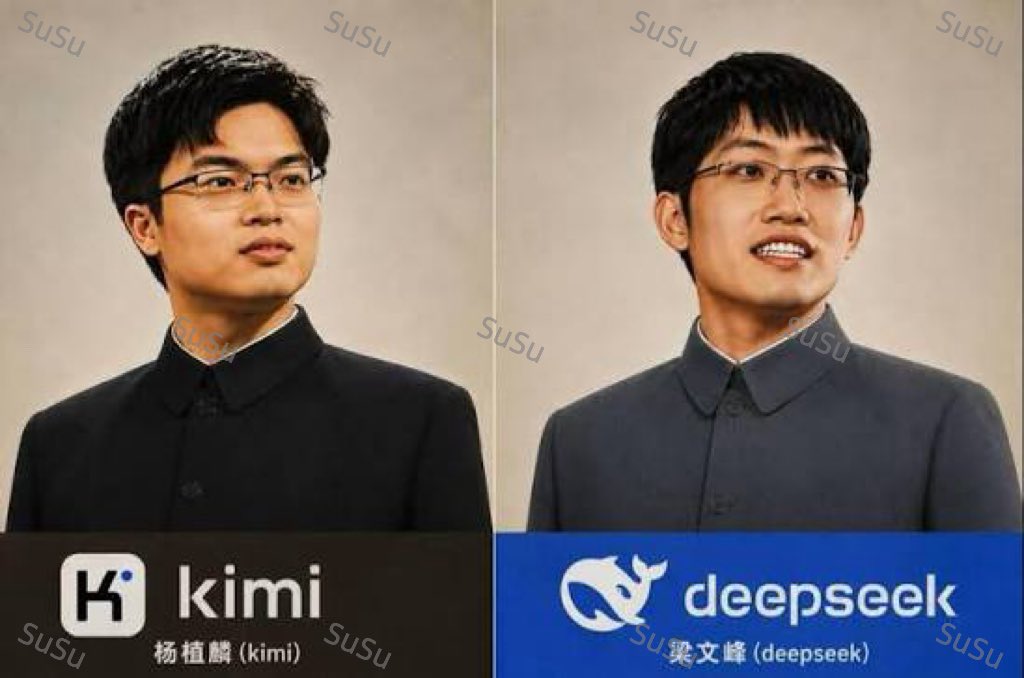
DeepSeek 是奥赛原教旨主义:几乎只看 ACM、ICPC、超算等顶级竞赛奖牌,偏爱年轻本科生;不要求丰富工程经验,甚至认为旧的大模型训练经验是包袱。面试重好奇心、技术热情和思维敏捷,而非框架熟练度;接受新人前两三个月不出成果,用半年到一年把天才养成全栈。
Kimi 是斯巴达实战派:哪里缺人就把重任直接扔给你,默认你能扛;不看竞赛光环,死磕是否真碰过 AI 前沿——模型反作弊、亲手跑大规模实验、跟进新模型发布。面试的 Coding 题极难,考察工程习惯和工具组织能力,写过提效工具直接高分;没耐心等成长,买的是在泥泞里打过仗的即战力。
底层原因只有一个:算力。DeepSeek 算力更充裕,能让奥赛金牌得主花半年读论文、试错底层架构、追求颠覆式创新;Kimi 每张卡都是金贵的,培训新人、排通信 Bug 是隐性浪费,必须筛出能瞬间把有限算力榨成模型提升的成熟工程师。
两条路都没有绝对对错:一条是算力霸权加顶级智力密度的精英路线,一条是极限资源加工程实战的铁军路线。在通往 AGI 的黑夜里,算力是柴火,人才是火种——柴火够不够,决定你敢不敢养纯粹的天才,还是只能招能立刻上战场的老兵。
正文完